rheoMesh — 設計
英語 | 日本語
rheoMesh の構成、設計の原則と品質ゲート、処理の流れと AMR のループ。rheoMesh のページから移した。現在の状況は rheoMesh のページにある。
構成
ひとつのコアと、ふたつのバックエンドから成る。
| 部分 | 内容 |
|---|---|
| コア | STL / OBJ の読み込みと検査(STEP は CAD の面ごとに三角形分割し、面のグループ付きの OBJ にしてから読む)、BVH とバッチ問い合わせ(線分と三角形の交差、最近点・最近特徴、高速巻き数による内外判定、符号付き距離)、設定と既存の解から作るレベルマップ、64 ビット Morton キーのブロック八分木(2:1 バランス、空間充填曲線による分割) |
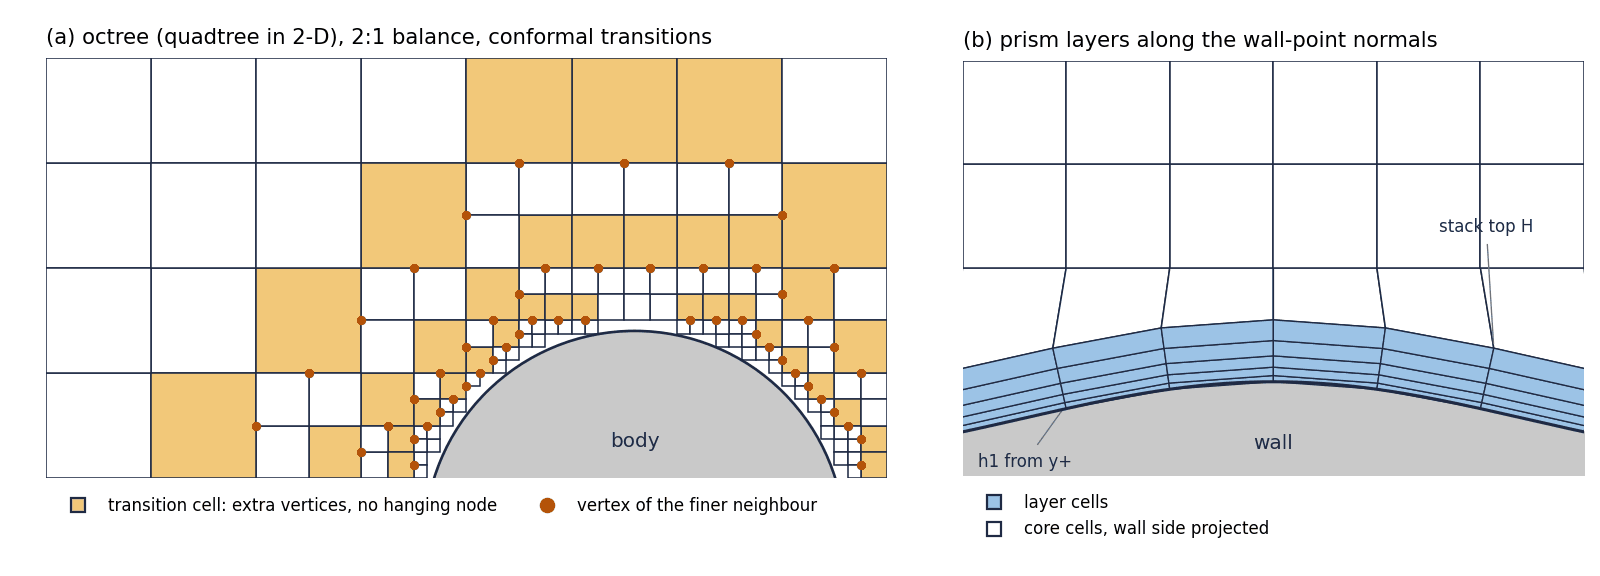
| FV バックエンド | OpenFOAM の polyMesh をファイルとして書き出す(ascii / binary、32 / 64 ビットラベル)。OpenFOAM のライブラリはリンクしない。六面体主体のセルに、ハンギング・ノードのない共形多面体の遷移セルを使う。境界は特徴線と角を固定して表面に投影し、プリズム層は表面側から決める(y+ から決める絶対的な第 1 層厚さ、厚さの予算、層を丸ごと外さずにテーパ) |
| LBM バックエンド | OpenRheo のブロックフォレスト。セルごとの流体 / 固体 / 境界フラグ、リンクごとの Bouzidi の q(D3Q19 / D3Q27)、レベル間の時間刻みの表。仕様とインタフェースヘッダはあるが、出力の実装はまだない |
設計の原則
- 八分木(ブロックの森)と 2:1 バランス: セルは 64 ビット Morton キーの八分木の葉で、隣り合う葉のレベル差は 1 以下。分割は空間充填曲線に沿う。
- 共形の多面体遷移: レベルの境界では、粗いセルが細かい側の面と頂点をそのまま持つ多面体になる。ハンギング・ノードはなく、どの面もちょうど 2 つのセル(または 1 つのセルと境界)が共有する。遷移用の六面体テンプレートは使わない。
- 特徴を固定した投影: 境界の点は表面へ投影し、特徴線と角の点はそこへ固定する。そのうえで面の修復と平滑化を行う。
- 表面側から決めるプリズム層: 第 1 層の厚さ h1 は、粗い格子で解いた流れ場の壁面せん断応力から求めた y+ をもとに絶対値で決め、層数と全厚さは境界層厚さの見積もりと厚さの予算(向かいの壁、凹の曲率、隙間)から壁の点ごとに決める。足りないところは層を丸ごと外さず、層数を 1 ずつ減らす(テーパ)。
- ひとつのレベルマップを FV と LBM で共有: 細分のレベルは設定と解から作るレベルマップにまとめ、FV の八分木と LBM のブロックフォレストが同じマップを読む。
- AMR はレベルマップからの作り直し(準静的): 解から指標を求めてレベルマップを更新し、メッシュ全体を作り直す。既存のセル(とくにプリズム層のセル)をその場で分割することはしない。
- 決定性とビット一致: 同じ入力と設定なら、スレッド数や計算機の種類によらず同じメッシュをビット単位で出す。CPU と GPU(stdpar)の間でも同じ結果を出すことを目標にする。結果はブロックと葉の順位で決まる位置に書き、ブロックをまたぐ集計はソートと一意化、プレフィックス和だけにして順序を固定する。
- stdpar と任意の CUDA: 並列化は OpenRheo と同じ ISO C++ 標準並列アルゴリズム(
nvc++ -stdpar=multicore|gpu、g++では TBB 上)。BVH は Morton 順に並べた三角形から、根から 1 レベルずつ下へ作り(Lauterbach ら 2009)、箱と巻き数のモーメントは最深レベルから 1 レベルずつ集める(原子操作なし)。幾何の問い合わせには任意の CUDA バックエンドを用意する(準備中)。 - 品質ゲート: 品質の指標は内部で計算し、checkMesh と同じ値になるよう較正した(最大・平均非直交性、歪度)。ゲートを満たさないメッシュは合格としない。
- 論文からのクリーンルーム開発(Apache-2.0): コードは仕様書(SPEC)と、そこに引用した論文・公開のファイル形式文書だけから書く。ほかのメッシュ生成器のソースは読まず、そこから導いた実装も認めない。仕様書の各アルゴリズムには文献の引用が付き、引用のないアルゴリズムや、ほかのメッシュ生成器の内部を名指す記述は取り込まない。
品質ゲート(FV、仕様書の値):
| ゲート | 値 |
|---|---|
| checkMesh(既定の閾値) | 失敗した検査なし |
| 最大非直交性 | 65° 以下 |
| 最大歪度 | 4 以下 |
| 凹セル、負の錐体積 | 0 |
| プリズム層の被覆 | 面の 98 % 以上に要求層数、要求厚さの 95 % 以上(面積重み) |
| 層数の変化 | テーパのみ(n、n−1、n−2、…)。層を丸ごと外さない |
決定性は、x86(384 スレッド)と aarch64(Grace 144 スレッド、A64FX 48 スレッド)で polyMesh の 8 ファイルの md5 が一致することで確かめた。プリズム層の被覆のゲートは、2026-10-30 時点の DrivAer のメッシュではまだ満たしていなかった(開発の経過の「2026-10-30 時点の状況(v0.1)」)。
処理の流れと AMR のループ
処理の流れ
%%{init: {'themeVariables': {'fontSize': '12px'}}}%%
flowchart LR
    G["形状<br/>STL / OBJ<br/>検査・特徴線"] --> O["八分木<br/>細分と 2:1 バランス"]
    LM["レベルマップ<br/>設定・AMR の指標"] --> O
    O --> C["分類<br/>巻き数で内外"]
    C --> E["抽出<br/>共形の遷移セル"]
    E --> P["投影<br/>特徴線と角を固定"]
    P --> L["プリズム層<br/>表面側で決めて押し出す"]
    L --> Q["品質<br/>最適化と検査"]
    Q --> FV["FV 出力<br/>polyMesh"]
    C --> LB["LBM 出力<br/>ブロックフォレスト<br/>(同じレベルマップ)"]
AMR のループ
ふたつの経路を並行して進めている。どちらも、指標からレベルマップを作り、メッシュを作り直して、次の計算を最初から行う(準静的な AMR)。
%%{init: {'themeVariables': {'fontSize': '12px'}}}%%
flowchart TD
    M["レベルマップ"] --> R["メッシュを作り直す<br/>rheoMesh"]
    subgraph FVT["FVM だけの経路"]
        F1["RANS 定常解<br/>simpleFoam"] --> F2["短い URANS<br/>または SIMPLE の反復ごとのばらつき"]
    end
    subgraph LBT["LBM を併用する経路"]
        B1["LBM の短い計算<br/>1 サイクル 1.5 s"]
    end
    R --> F1
    R --> B1
    F2 --> S["統計<br/>平均、u'rms"]
    B1 --> S
    S --> I["指標<br/>u'rms、h|ω|/U、LBM の非平衡<br/>平均と標準偏差で規格化"]
    I --> K["印付け<br/>下限 ε = 1 と Dörfler θ = 0.5<br/>NUAMR の流管"]
    K --> M
K --> X{"止める判断<br/>Cd、逆流域、スペクトル"}文献
- C. Lauterbach, M. Garland, S. Sengupta, D. Luebke, D. Manocha: Fast BVH construction on GPUs, Computer Graphics Forum 28 (2), 375–384, 2009.
詳しい結果と文献調査で引いた文献は、それぞれのページにある。