設計思想
英語 | 日本語
OpenRheo が何を選び、何を選ばなかったかを述べます。結論だけでなくなぜそうしたかと まだできていないことも書きます。
1. 数値核 — 標準 C++ stdpar による単一ソース
数値核は ISO C++ 標準並列アルゴリズム(stdpar)で書いた AMR-LBM です。
同一のソースが nvc++ -stdpar=gpu で GPU に、-stdpar=multicore で CPU に載ります。
ERCOFTAC case 41 には、選んで使う CUDA 経路もあります。-cuda を付けてビルドし、LBM_CUDA で選びます。stdpar 版とビット単位で一致します。-cuda を付けなければ、CUDA の部分は空のままです。
// 同じ1行が GPU にも CPU にも展開される
std::for_each(policy, cells.begin(), cells.end(), [=](std::size_t c) { ... });
なぜ LBM か: OpenFOAM などの FVM は陰的に線形方程式を解くため GPU 化に限界があります。 LBM は衝突と並進がほぼ完全に局所・陽的で、GPU と相性が良い。日本のスパコンが GPU 中心(Miyabi、富岳NEXT)へ移行している以上、これは実務的な選択です。
なぜ stdpar か: 移植性のためです。ただし万能ではありません — 現状 stdpar の GPU オフロードは実質 NVIDIA のみで、AMD/Intel や富岳への展開は Kokkos 等への 移行が必要になる可能性があります。この点は正直に認識しています。
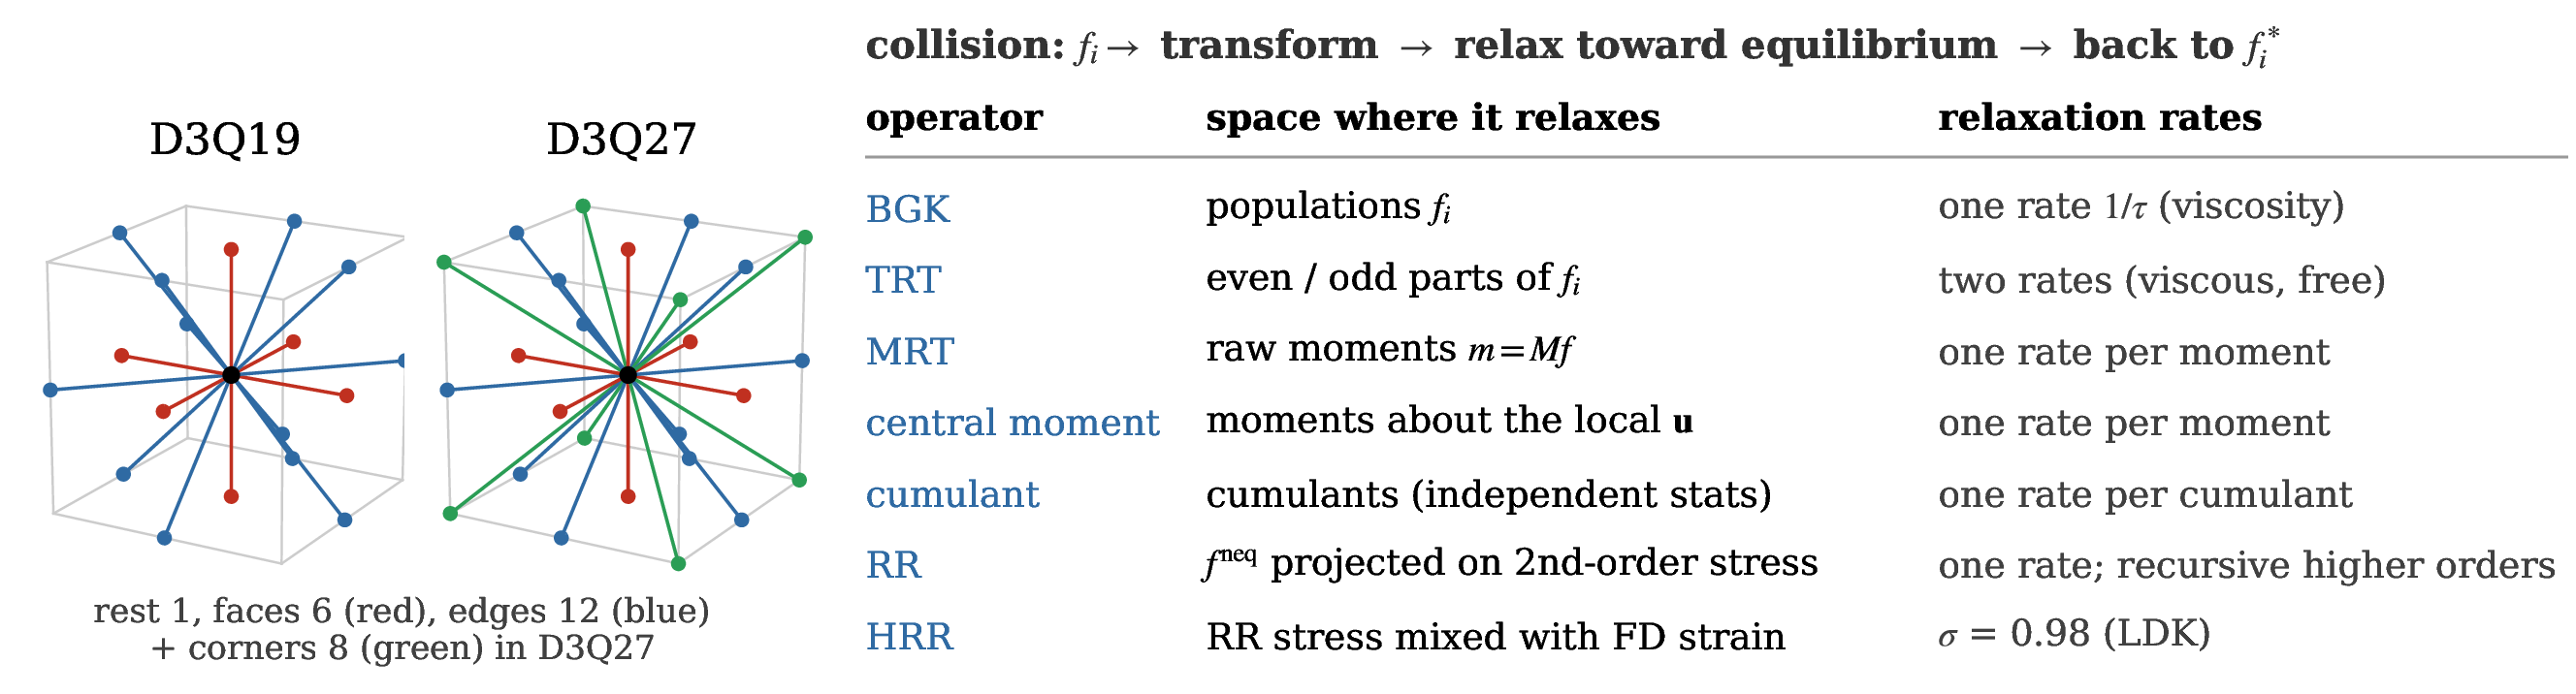
速度格子と衝突演算子(オープンCAEシンポジウム2026 の発表から):流れの速度格子は D3Q19(静止 1、面 6、辺 12)と D3Q27(さらに角 8)です。衝突演算子は、分布関数をどの空間に変換して平衡へ緩和させるかで分かれます。HRR は集合住宅の LDK の計算で σ = 0.98 を使いました。
2. ブロックフォレスト AMR
空間適応は ブロックフォレスト AMR(小さな固定サイズのブロックを八分木で管理)で、 waLBerla や青木研の実装と同じ系統です。物体近傍だけを細かくし、遠方は粗いまま保ちます。
粗細界面の扱いが AMR の品質を決めます。OpenRheo は保存型の partition の結合(partition2)と2層バッファを 採用し、界面で生じる擬似音波ノイズを AMR・数値検証 のケースで定量評価しています。 フォレストの作り方、試した結合、測った結果は AMR にまとめています。
3. モジュール契約 — LLM が「合成」できる形
物理はモジュールとして切り出し、ケースはそれを組み合わせて書きます。 既存ベンチマークを複製して改変する方式は採りません。
モジュールには2種類あります。重い方を過剰適用すると、物理ごとに格子を再実装する 羽目になります。
| 種類 | 内容 | 使いどころ |
|---|---|---|
| ステッパ | 自前の分布関数と時間発展を持つParams / State / init / step |
物理が場を増やすとき(温度・スカラー・相場) |
| クロージャ | 既存ステッパに差し込む純関数nu(shear), F(u,x) |
物理が係数だけ変えるとき(非ニュートン粘性・Darcy抗力・電気浸透力) |
クロージャは合成できます。多孔質中の冪乗則流体は、nu_powerlaw が緩和時間を、
force_darcy が体積力を担当するだけで表現できます。
現在のモジュール:
| モジュール | ゲート | 主要な証拠 |
|---|---|---|
lattice2d.hpp |
下記経由 | D2Q9+D2Q5 の格子定数を共有 |
advection_diffusion.hpp |
advection_diffusion |
解析 Green 関数と L2 3.4e-3、収束確認 |
thermal_ddf.hpp |
thermal_ddf ほか |
Nu 誤差 0.00% vs de Vahl Davis |
closures.hpp |
closures |
流動・Darcy・EDL・潜熱の解析極限 |
rigid_body.hpp |
rigid_body |
移動境界・運動量交換・Newton 積分 |
radiative.hpp |
radiative |
Beer-Lambert と収束次数、純散乱の保存 |
electrokinetics.hpp |
electrokinetics |
Gouy-Chapman が Debye-Hückel に漸近 |
まだインライン実装のまま: pnp_full2d の多イオン輸送、自由表面の森 AMR 変種、
最適化/UQ の3件。隠さず記しておきます。
4. ゴールデンゲート — LLM の編集ループに必要な網
各モジュールは原著論文の公表値に対する ctest で門番されています。 これは飾りではなく、実際に2度バグを捕まえました。
- 熱モジュール抽出時、Nusselt 積分の
H/dT係数を落として 2.243 のはずが 0.035 に。 ゲートが即座に失敗しました。 - レイリー・ベナール移行時、マクロ量の更新が1ステップ遅れて成長率が 0.05% ずれました。 ビット同値を受入条件にしていたため発見できました。
インライン実装のベンチマークにはこの網がありません。だからモジュール化するのです。
5. LLM は数値ループの中に入らない
これは譲れない原則です。LLM はモデルを選びパラメータを埋めるだけで、 走るカーネルは決定論的な C++ のままです。再現性を犠牲にしません。
既存の CFD コードを LLM エージェントに操作させる取り組みも増えています。ただしその場合、メッシュの頑健さ、結果の再現性、GPU での性能は、元のコードの性質で決まります。OpenRheo は、エージェントが組み合わせ、自分で検証しやすいことを前提に、数値計算の中核(モジュール契約、ゴールデンゲート、rheoMesh)そのものを設計しています。
教師となるクラウド LLM が RAG・メモリ・ゴールデン事例を整備し、 現場のローカル LLM がそれを使って自律駆動する、という二段構えを想定しています。 → ローカルLLMの比較
6. マルチレベル解析
全てを非定常 LBM で解くのは現実的ではありません。空間分布が重要でない系は 1D モデル、定常で良い系は FVM(OpenFOAM 駆動)、非定常で空間分布が要る系だけ GPU の LBM に回す、という役割分担を設計に組み込んでいます。
1D と定常 FVM は CPU 数コアで足りるため、GH200 の Grace CPU と Hopper GPU を 同時に使い切れます。
現状: 1D 層(orheo-1d)と LBM 層は動いていますが、層をまたぐ自動的な
受け渡しはまだ検証中です。ここが最大の差別化要素であり、最大の未完成部分です。
7. ライセンス — Apache-2.0 とクリーンルーム
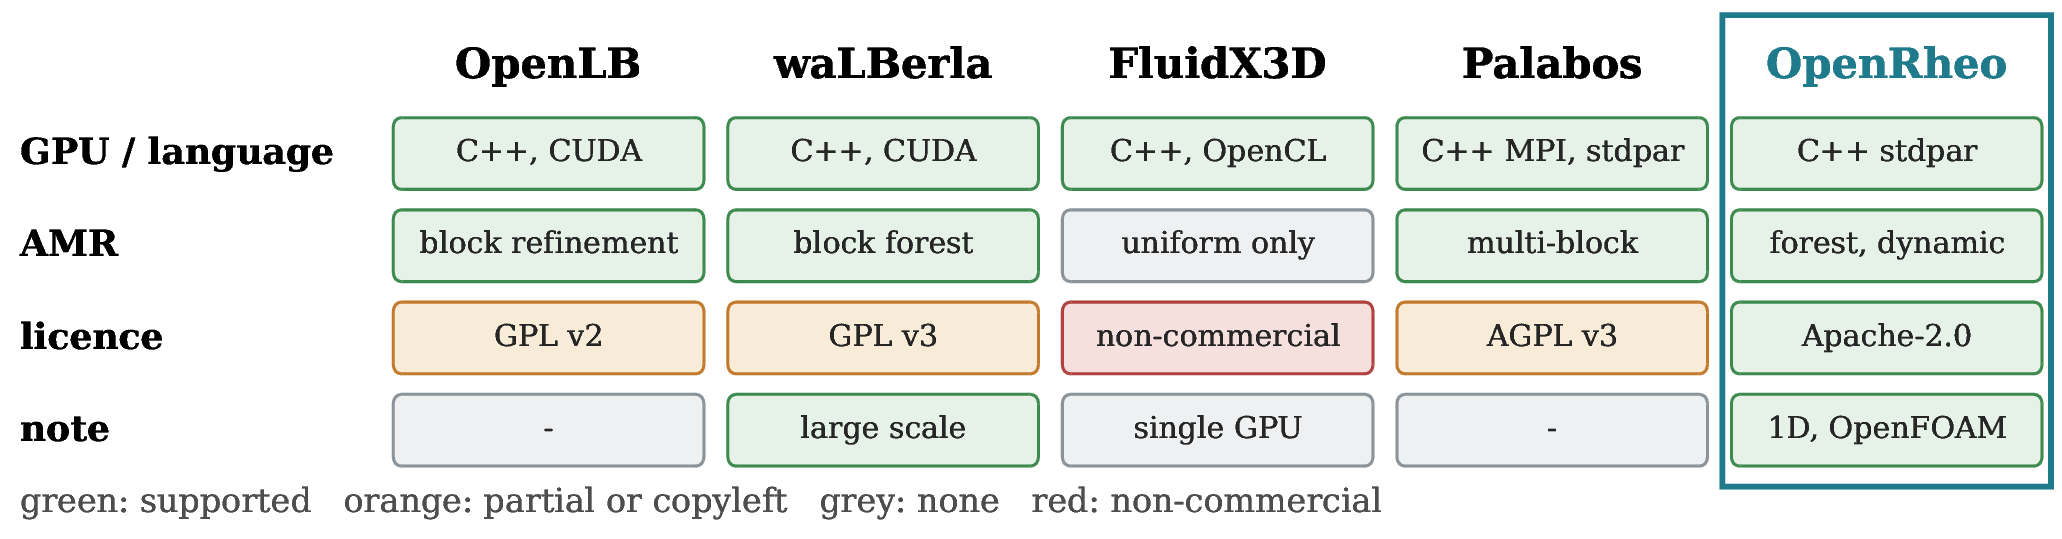
OpenRheo は Apache-2.0 です。主要なオープンソース LBM で唯一 permissive (商用利用可)である点が明確な差別化です。
| コード | ライセンス | 商用利用 |
|---|---|---|
| OpenRheo | Apache-2.0 | 可 |
| OpenLB | GPLv2 | ソース公開義務 |
| Palabos | AGPLv3 | ネットワーク利用でも公開義務 |
| waLBerla | GPLv3 | ソース公開義務 |
| FluidX3D | 独自 | 非商用のみ |
機能の比較(オープンCAEシンポジウム2026 の発表から)。緑は対応、橙は部分的な対応またはコピーレフト、灰は無し、赤は非商用。
そのため他コードのソースは一切読まず、移植もしていません。使うのは 「どのケースが存在するか」という事実と、原著論文が公表している基準値だけです。 検証はすべて原著文献に対して行い、他コードの出力に合わせることはしません。 → 他コードとの比較、LBM の機能比較表
なお「標準 C++ stdpar」自体は独自の売りではありません。Palabos も 2025 年に stdpar でマルチGPU化しています。差別化は Apache-2.0 + マルチレベル統合 + LLM エージェントの組み合わせに置いています。