AMR
英語 | 日本語
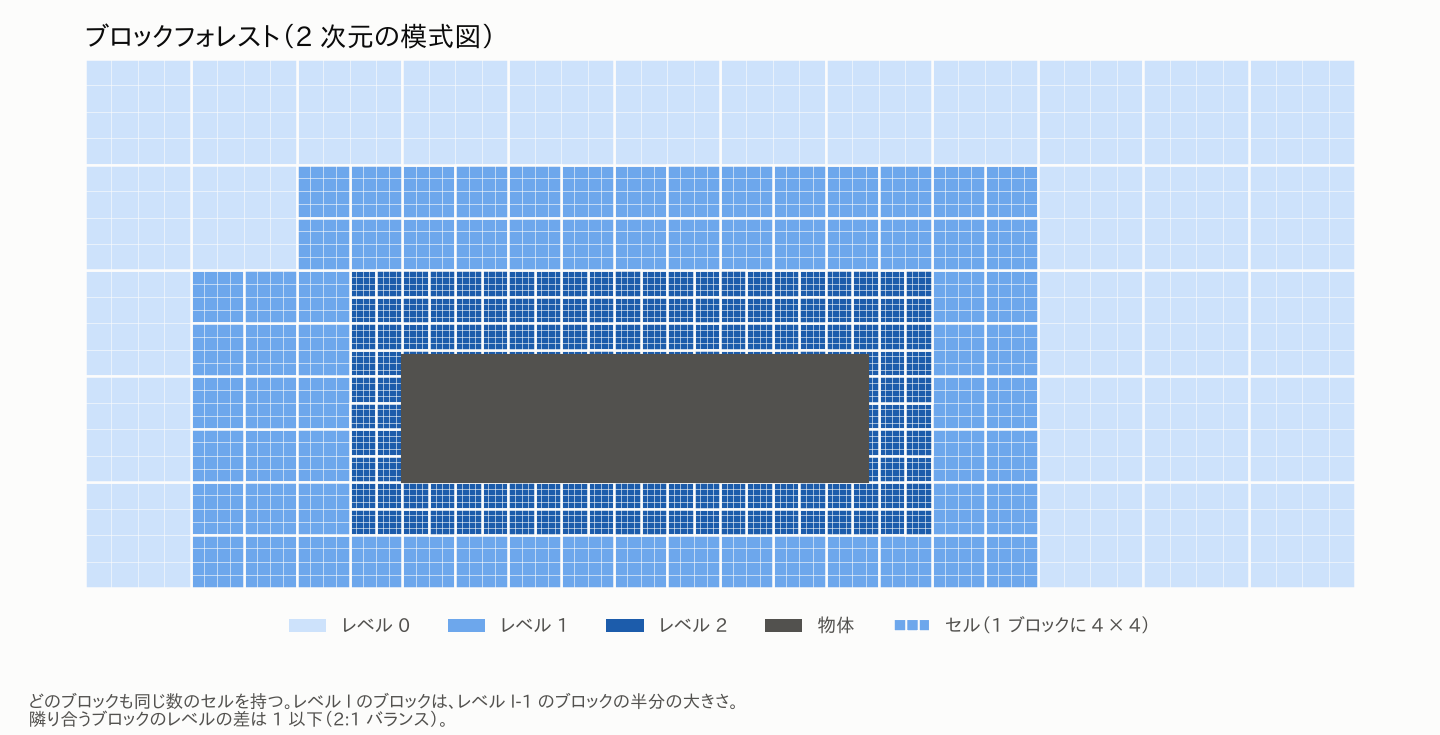
OpenRheo は、格子をブロックフォレストで細かくします。計算領域を、どれも同じ数のセルを持つブロックに分け、細かくするブロックは、大きさが半分のブロック 2 × 2 × 2 個に置き換えます。隣り合うブロックのレベルの差は 1 以下(2:1 バランス)で、細かいレベルは粗いレベルの 1 ステップのあいだに 2 ステップ進みます。このページでは、フォレストの作り方、レベルの間のデータのやりとり、どこを細かくするか、測った結果、残っている課題を説明します。もとになった設計の記録は、最後に並べています。
フォレスト
木の構造は CPU 側に置きます(forest_topology.hpp の OctForest。細分化、粗大化、2:1 バランス、Morton 順)。セルのデータは、GPU 上の 1 本の配列にまとめて置きます(forest_field.hpp の ForestField)。ブロックの一辺のセル数はドライバごとに決めていて、D3Q19 のフォレストのドライバ(forest_ahmed_body.cpp)では 4、D3Q27 の Ahmed のドライバでは既定で 8(KNB)、複数 GPU のチャネルのドライバでは既定で 16 です。
葉のブロックは Morton 曲線の順に並べ、重みが等しくなるように切り分けて MPI のランクに配ります(forest_partition.hpp。ブロックの重みは 2^level)。
フォレストより前に作った、密な格子の AMR(block_forest.hpp。粗い格子の上に、壁の帯と内部の箱の細かいパッチを重ねるもの)も残っていて、テストも続けています。壁の帯の静的な AMR を最初に測ったのは、こちらです(下の表)。
レベルの間のデータのやりとり
いちばん苦労したのはここです。2026 年 7 月に 3 通りの結合を作りました。ドライバ forest_ahmed_body.cpp では、いまも 3 通りとも選べます(引数 coupling)。
| coupling | 方法 | 結果 |
|---|---|---|
| 0、partition | 粗い葉ブロックを細かい子ブロックに置き換える。レベルの境目では、コピー、explosion(3 線形補間)、coalescence(2³ 個の平均)でデータを渡し、時間は 1 ステップ遅れて合わせる | Ahmed body は max_level >= 1 で発散した(200〜600 ステップあたりで NaN)。12 回直しても治らず、細分化しない max_level = 0 だけが安定した(2026-07-13) |
| 1、overlap(「影のブロック」) | 粗いレベルを全域で解き、その上に細かいレベルを重ねる。細かいレベルの内部の値を粗いレベルに戻す | 安定したが、作りの上で質量が保存されない。遠方での abs(ρ − 1) の平均は、細分化なしの 0.00037 から 3 レベルで 0.00095 に増えた(2026-07-13)。2 層のバッファと正則化した衝突(RR)を加えると、深いレベルの推奨の設定になったが、レベル 3〜4 の力は正しくならなかった(2026-07-14) |
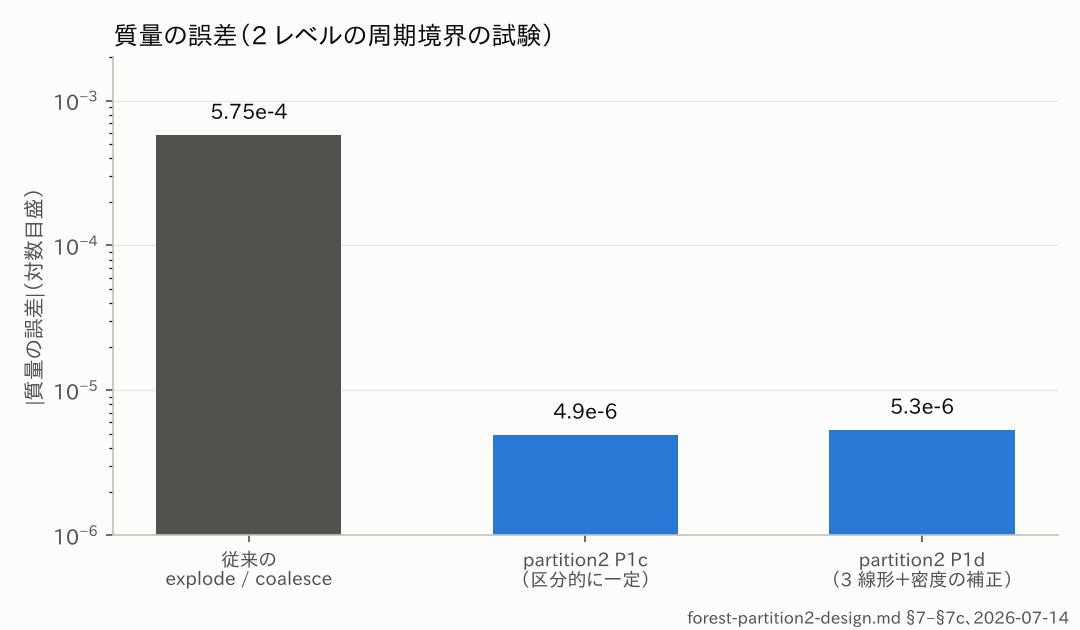
| 2、partition2 | もう一度 partition にし、explosion を保存型にした。細かいレベルの分布関数を、覆っている粗いセルの密度に合わせて補正する | 保存と安定性の 4 つの関門をすべて通った。質量の誤差は約 100 分の 1 になった(図)。D3Q27 の経路は、2 層のバッファと組み合わせて、いつもこの結合を使う(2026-07-14) |
forest_ahmed_body.cpp の既定値は coupling = 0 でした。同じファイルのコメントに max_level >= 1 で発散すると書かれている結合です。2026-11-02 から、D3Q27 の経路と同じ 2 にしました。
どこを細かくするか
- 静的に決める: 表面のまわりの帯、入れ子の箱(
OFBOX)、後流を囲む箱、表面に沿った殻(SURFBAND)、CSV ファイルから読むレベルの分布(LEVEL_MAP)。forest_mesh_spec.hppは、外接する箱から入れ子の箱を作ります。 - センサーで決める: 分布関数の非平衡の部分、渦度、τ-pass センサー(
forest_taupass)。τ-pass は、2 つのレベルの解から局所の誤差を見積もり(Richardson 外挿)、壁のための表面の成分も持ちます。 - 計算中に作り直す:
forest_regridとforest_regrid_latが、REGRID_EVERYステップごとにフォレストを作り直します。バッファと最低の滞在時間で、ブロックが細かくなったり粗くなったりを繰り返すのを防ぎます。新しい細かいブロックには、勾配を制限した(minmod)保存型の補間で値を入れます。保護の床(protection floor)は、動く境目を物体から離しておき、作り直しの影響が力に入らないようにします。自由表面のソルバーは界面に沿って細かくし、作り直しのあいだも液体の量を保ちます。
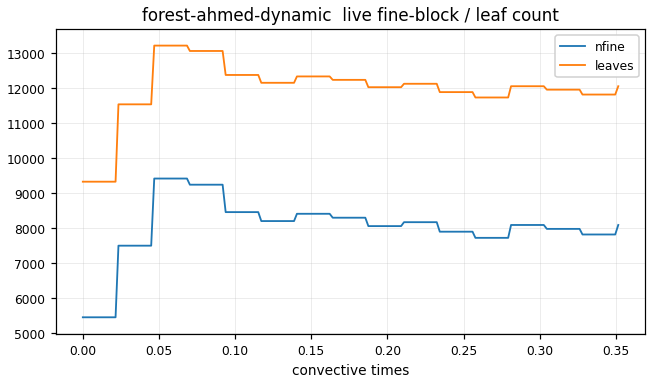
動的な Ahmed のケース(forest-ahmed-dynamic)では、細かいブロックの数が流れに合わせて変わります。
物体の内部。 BAND_SOLID=<n> を指定すると、いちばん細かいレベルに残す固体を表面から n セルだけにし、それより奥の固体のブロックは粗いままにします。Ahmed body(nh16、4 レベル)では、固体のセルが 43 % 減り(6,967,754 → 3,985,754)、GPU のメモリが 1.6 GB 減りました。抗力は 400 ステップのあいだ同じ値でした。既定では使いません。
測った結果
| 内容 | 結果 | 記録 |
|---|---|---|
| キャビティ流れ Re = 1000、MRT、壁の帯の AMR | 細かい格子に対する中心線の誤差は 0.0407。粗い一様格子は 0.0523 で、AMR が 22 % よい(2026-07-10) | native-amr-backend.md |
| 同じ計算を CPU(x86、GCC)と GPU(GH200、nvc++)で | ビット単位で一致 | native-amr-backend.md |
| partition2、2 レベルの周期境界の試験 | 質量の誤差 4.9e-6 / 5.3e-6(従来の方法は 5.75e-4) | forest-partition2-design.md |
| MPI、一様な 3 次元の試験、GH200 1 台と 2 台 | 逐次の計算とビット単位で一致。弱スケーリングで 1577 → 2660 MLUPS(約 84 %、2026-07-17) | mpi-amr-design.md |
| 物体の内部を粗くする、Ahmed nh16 | 固体のセル −43 %、メモリ −1.6 GB、抗力は 400 ステップのあいだ同じ | solid-interior-coarsening.md |
結合と同じくらい、衝突演算子の選び方も結果を左右します。TRT は AMR と組み合わせると発散するので、AMR では MRT を標準にしています。深いレベルでは、正則化した衝突 RR がいちばんよい結果でした。
残っている課題
- 深いレベル(3〜4)で物体にかかる力は、まだ信用できません。
- GPU 3 台以上での計算は、まだ測っていません。
BAND_SOLIDは既定で使わない設定のままです。使う設定にする予定でした。- センサーの設計で決めた関門(誤差との順位相関、計算量あたりの誤差の減り方)の結果は、記録にありません。
設計の記録
凍結した記録です。更新せず、日本語にも訳しません。
- native-amr-backend.md — ネイティブのバックエンドと最初の AMR(2026-07-09〜07-11、日本語)
- forest-ahmed-design-space-study.md — フォレストの Ahmed の作業記録と、
max_level >= 1での発散 - forest-overlap-coupling-design.md、forest-conservative-coupling-design.md、forest-coupling-rewrite-design.md — overlap の結合
- amr-coupling-retrospective.md、amr-interface-noise-soa.md — ふり返りと、境目のノイズについての文献
- forest-partition2-design.md — 保存型の partition の結合
- dynamic-amr-design.md、dynamic-amr-design-review.md — 動的な AMR
- amr-sensor-brief.md、amr-sensor-design.md — センサー
- mpi-amr-design.md — MPI
- solid-interior-coarsening.md — 物体の内部を粗くする