wall-mounted-cube
英語 | 日本語
概要: チャネル床面に置いた立方体まわりの流れ(ERCOFTAC case 41 / SIG15 6.3(OpenCAE V&V の OpenFOAM ケース、ディレクトリ名は case06.2)、Martinuzzi & Tropea の実験、Re_H = 40,000)を、D3Q27 キュムラント LBM-LES で解く。格子を H/16、H/32、H/48 と細かくして、LDA の平均速度・レイノルズ応力と比べる。H/48 の計算(1.23 億セル)は Miyabi-G の GH200 8 台で行い、その速度とスケーリングも測った。途中経過のまとめ(2026-10-27)。2026-10-29 の進捗は下記。
進捗(2026-10-29)
- 2026-10-28 の壁モデルの変更は、このケースに影響しない。 D3Q27 の壁モデルは、壁に対する相対的な接線速度を使うように変わった(DrivAer の計算の動く床と車輪のため)。立方体には動く壁がなく、変更前後で分布関数のチェックサムがビット単位で一致した(GB200、H/32 は 20 + 400 ステップ、H/48 は 20 + 200 ステップ、stdpar と CUDA 版の各モード:初版、新レイアウト、FP32 保存、FP32 衝突)。このページの結果はすべてそのまま有効である。
- Miyabi-G での複数ノードの CUDA(1 ノードに GH200 1 基、1 ノード 1 MPI ランク、CUDA 版は計算ノードで
-cudaを付けてビルド、2026-10-28 のソース)。2026-10-28 の計算は起動時に失敗していた(実行ファイルが未ビルドだった)ため、2026-10-29 に再実行した。s/step は力の出力を含む。FP64 のチェックサムは stdpar と一致し(H/48ec36499638244575、H/32d33bf4bdf3983bd4)、OVERLAP=3 でも結果は変わらない。
| H/48(スパン 24 H)、s/step | 2 ノード | 4 ノード | 8 ノード |
|---|---|---|---|
| stdpar、縮小デバイス halo(2026-10-27) | – | – | 0.02704 |
CUDA LBM_CUDA=3(FP64) |
0.01511 | 0.00903 | 0.00574 |
CUDA FP64 + OVERLAP=3 |
0.01455 | 0.00813 | 0.00503 |
CUDA LBM_FP32=2(FP32 衝突) |
0.01259 | 0.00779 | 0.00503 |
CUDA FP32 衝突 + OVERLAP=3 |
0.01200 | 0.00683 | 0.00427 |
ノード間では、内部のカーネルと MPI の重ね合わせが効く(H/48、8 ノードで 12〜15 %)。1 ノード内では効かなかったのと対照的である。H/48 を FP32 衝突と重ね合わせで GH200 8 基に載せると 0.00427 s/step(29 GLUPS)で、stdpar の 6.3 倍である。H/32(スパン 7 H)は 8 ノードには小さすぎる(4 ノードの 0.00080 に対して 0.00059 s/step)。
1 ノード(2026-10-29):H/48 は Miyabi-G の GH200 1 基では動かない(準備の段階で、ジョブのメモリ上限 100 GiB を超えて止められる)。H/32 は GH200 1 基で、FP64 が 0.00253 s/step(stdpar の 0.0166 の 6.6 倍)、FP32 衝突が 0.00206 s/step(8.1 倍)で、チェックサムは複数ノードと同じ。OVERLAP は 2 ランク以上が必要(1 ランクでは HALO_MEM が legacy になる)。 - 立方体前方の壁近くの乱れ(下の課題):未着手。最初の作業は、引き続き x 方向の断面での u_rms の測定である。
構成
立方体(一辺 H)は高さ 2H の閉じたチャネルの床に立つ。領域は立方体前面の 10H 上流から 12H 下流まで(x/H = -10〜12)。座標は実験と同じく、x が流れ方向、y が床からの高さ、z がスパン方向。
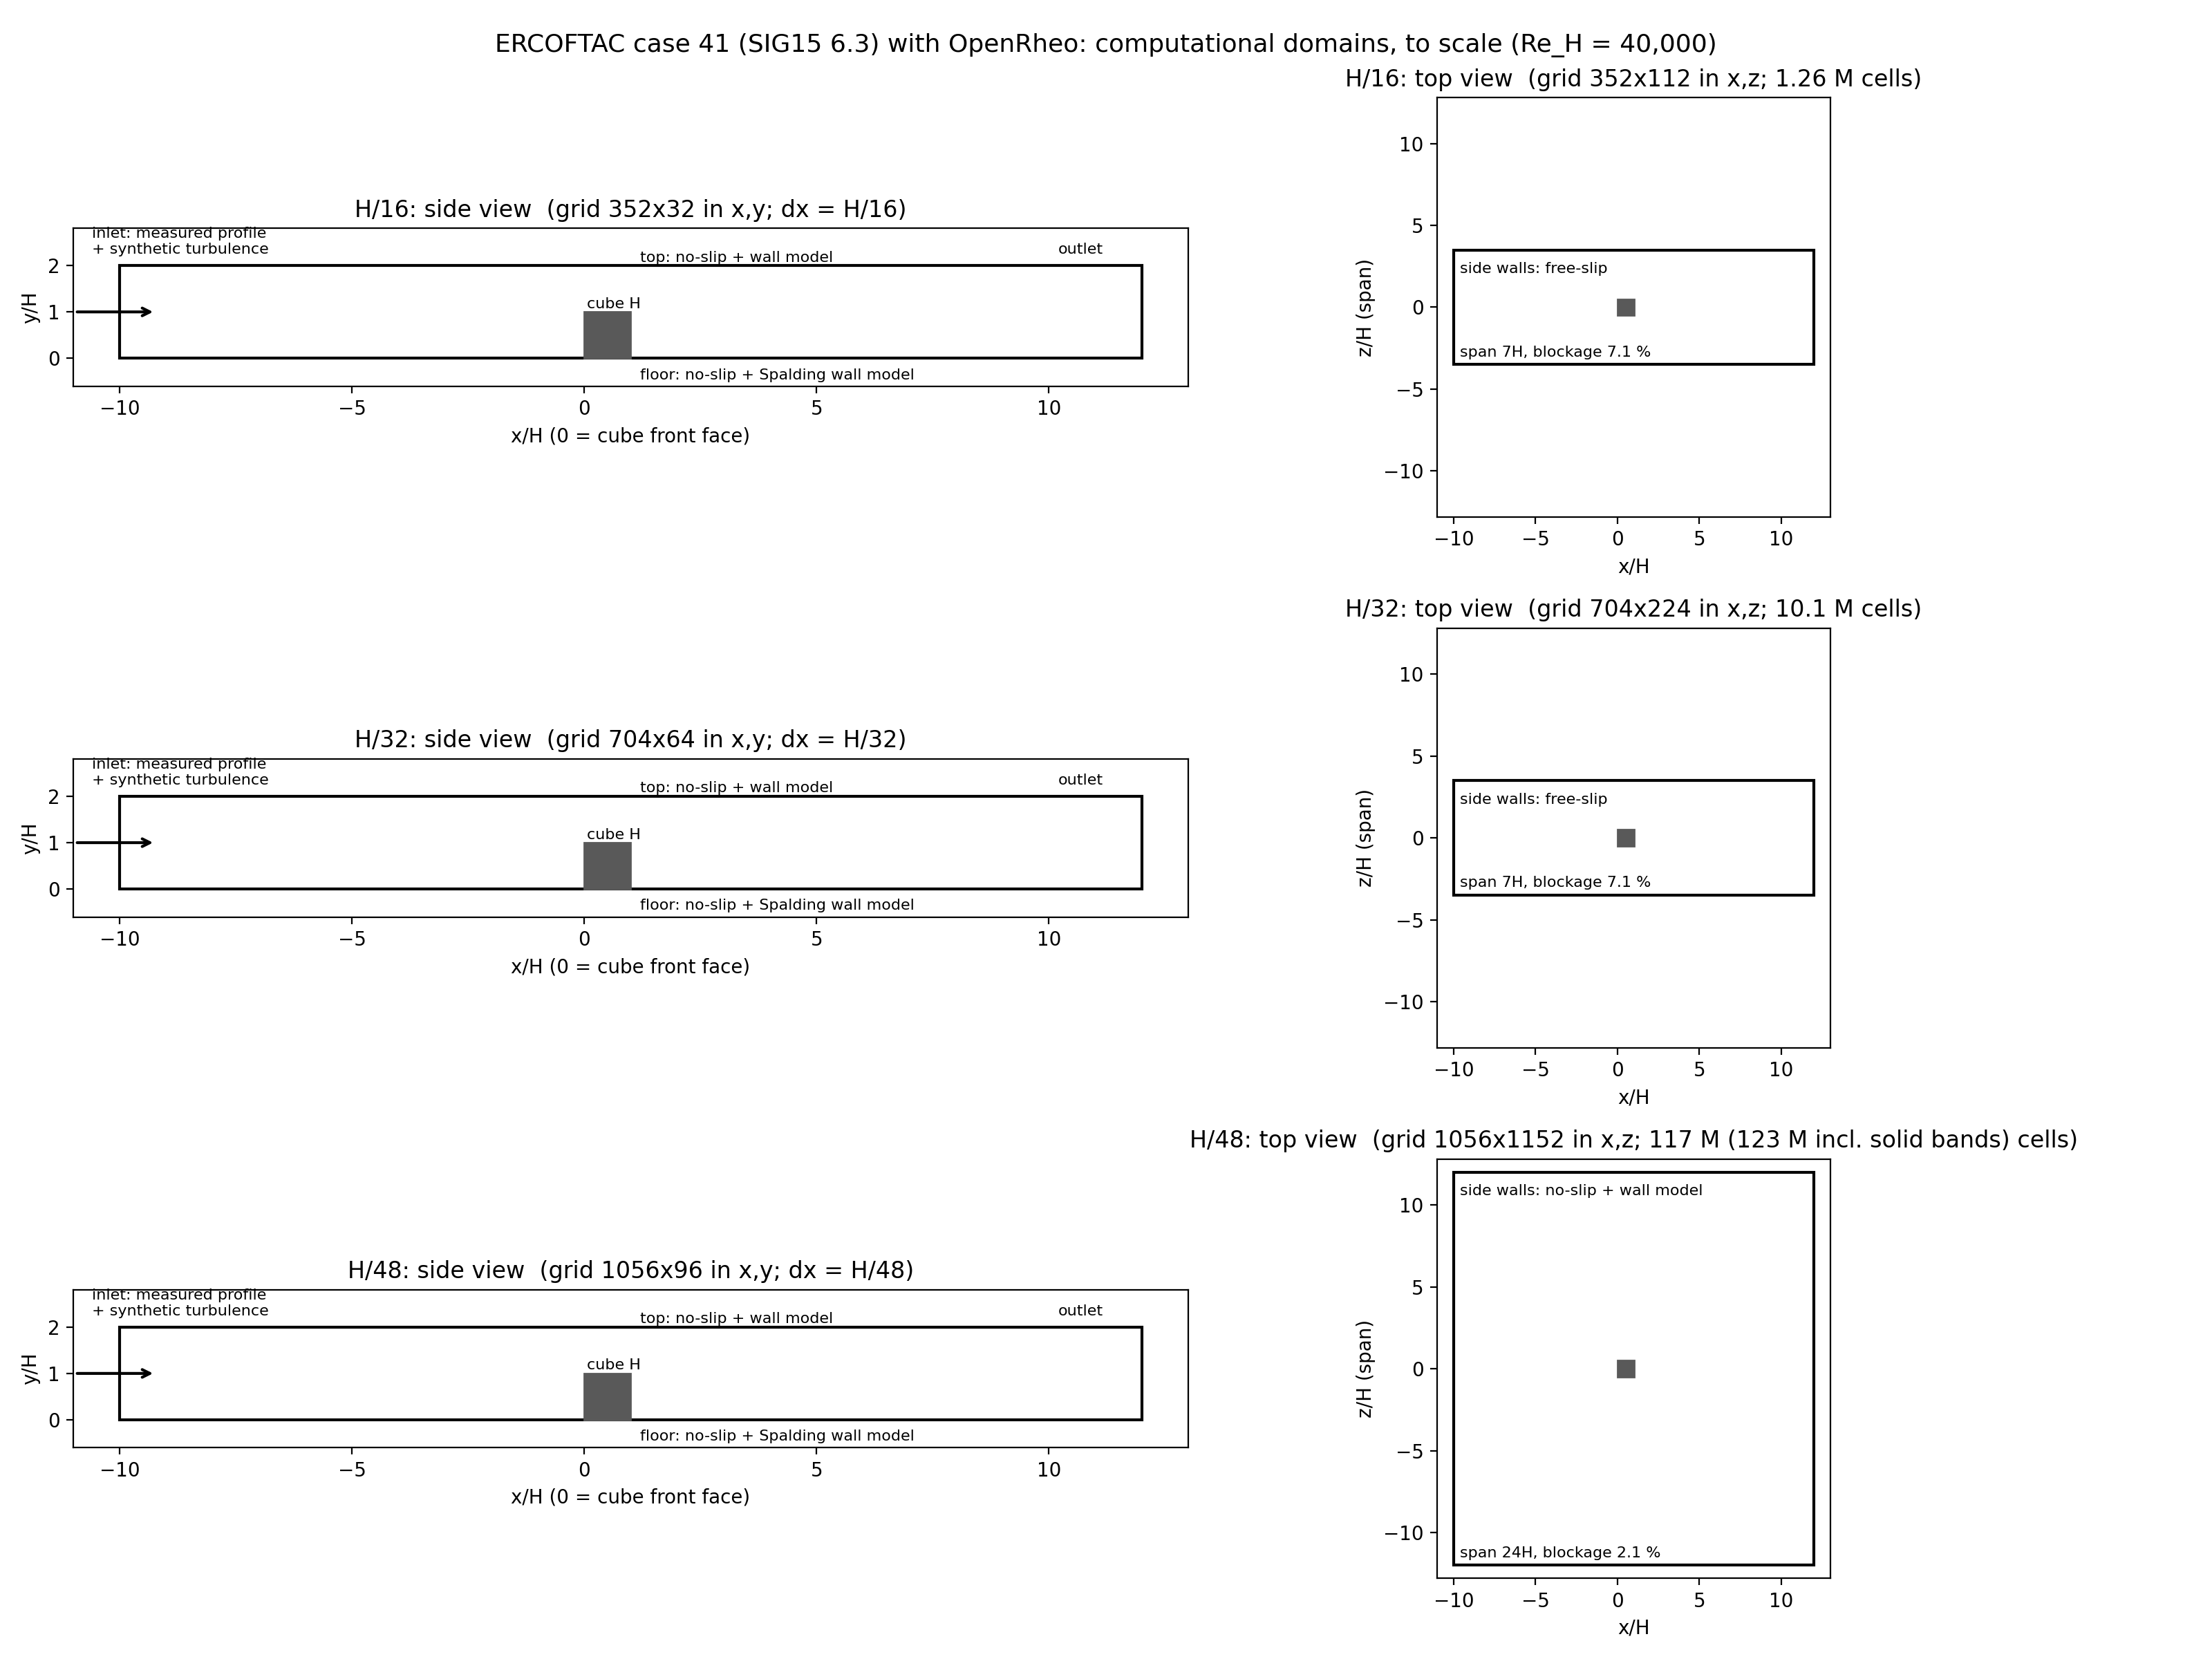
| 項目 | H/16 | H/32 | H/48 |
|---|---|---|---|
| 格子幅 | H/16 | H/32 | H/48 |
| セル数 | 126 万 | 1,010 万 | 1.17 億(側壁の固体帯を含めて 1.23 億) |
| スパン | 7H、側面は free-slip | 7H、側面は free-slip | 24H(実験と同じ)、側壁は no-slip + 壁関数 |
| 閉塞率 | 7.1 % | 7.1 % | 2.1 %(実験と同じ) |
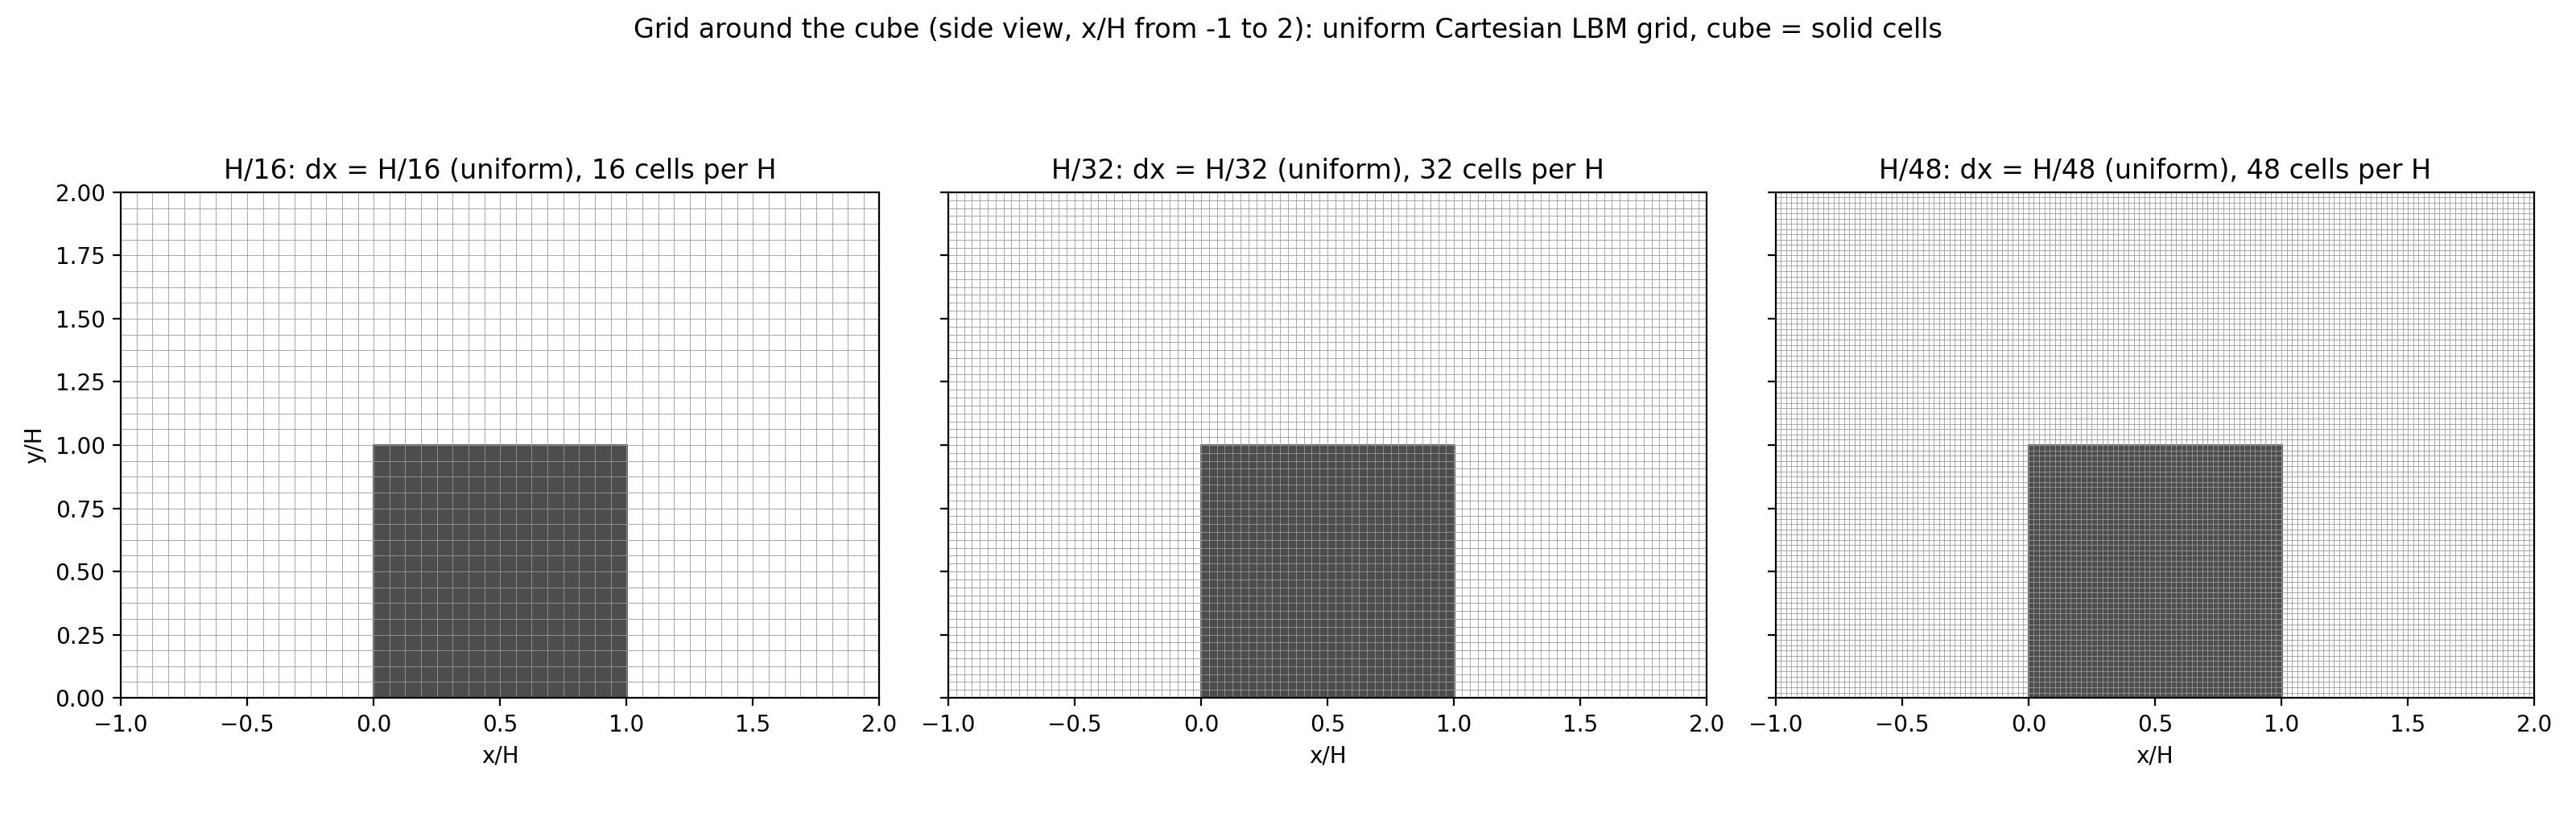
立方体まわりの格子(側面、x/H = -1〜2)。一様な直交格子で、立方体は固体セル。立方体の高さ方向に 16、32、48 セル。
共通の条件:
| 項目 | 値 |
|---|---|
| 格子 | D3Q27、キュムラント衝突、一様格子(細分化なし) |
| LES | Smagorinsky(C_s = 0.10) |
| 壁 | 床・天井・立方体(H/48 では側壁も)に Spalding 則の壁関数。壁は格子面に一致する階段状の bounce-back で、格子生成は不要 |
| 流入 | x/H = -18 で測った十分発達したチャネル流の平均速度とレイノルズ応力(LDA)に、デジタルフィルタの人工乱流(長さスケール L_x = 1.0H、L_y = L_z = 0.3H)を重ねる。助走計算(precursor)やリサイクルはない |
| 流出 | 圧力一定 |
結果(平均場)
H/16 と H/32 は 1 GPU で、H/48 は 8 GPU で回した。H/48 の統計は 118 H/U_b(5,671 サンプル)、その前の助走が 45 H/U_b。
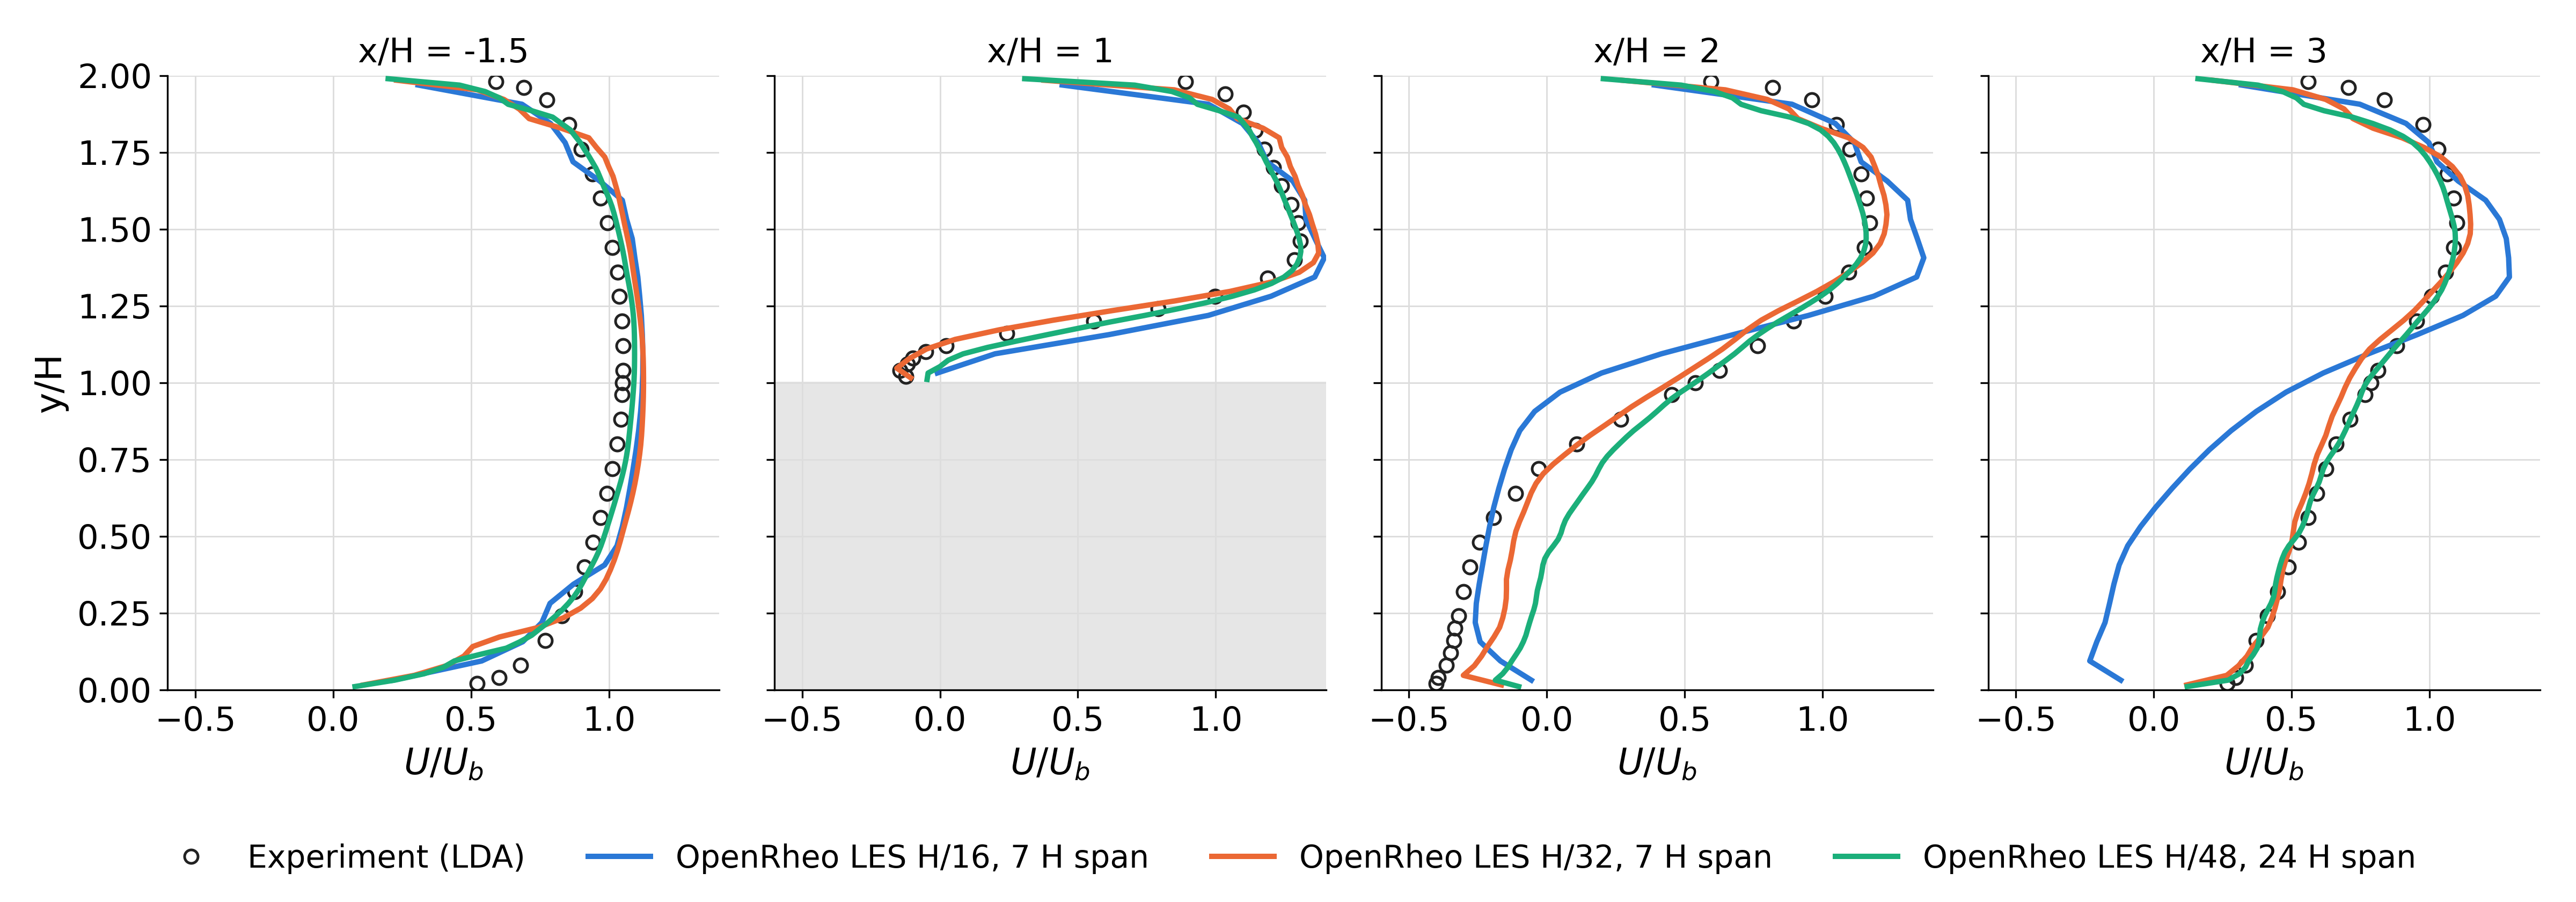
中心面(z = 0)の平均速度 U/U_b。○ は実験(LDA)。
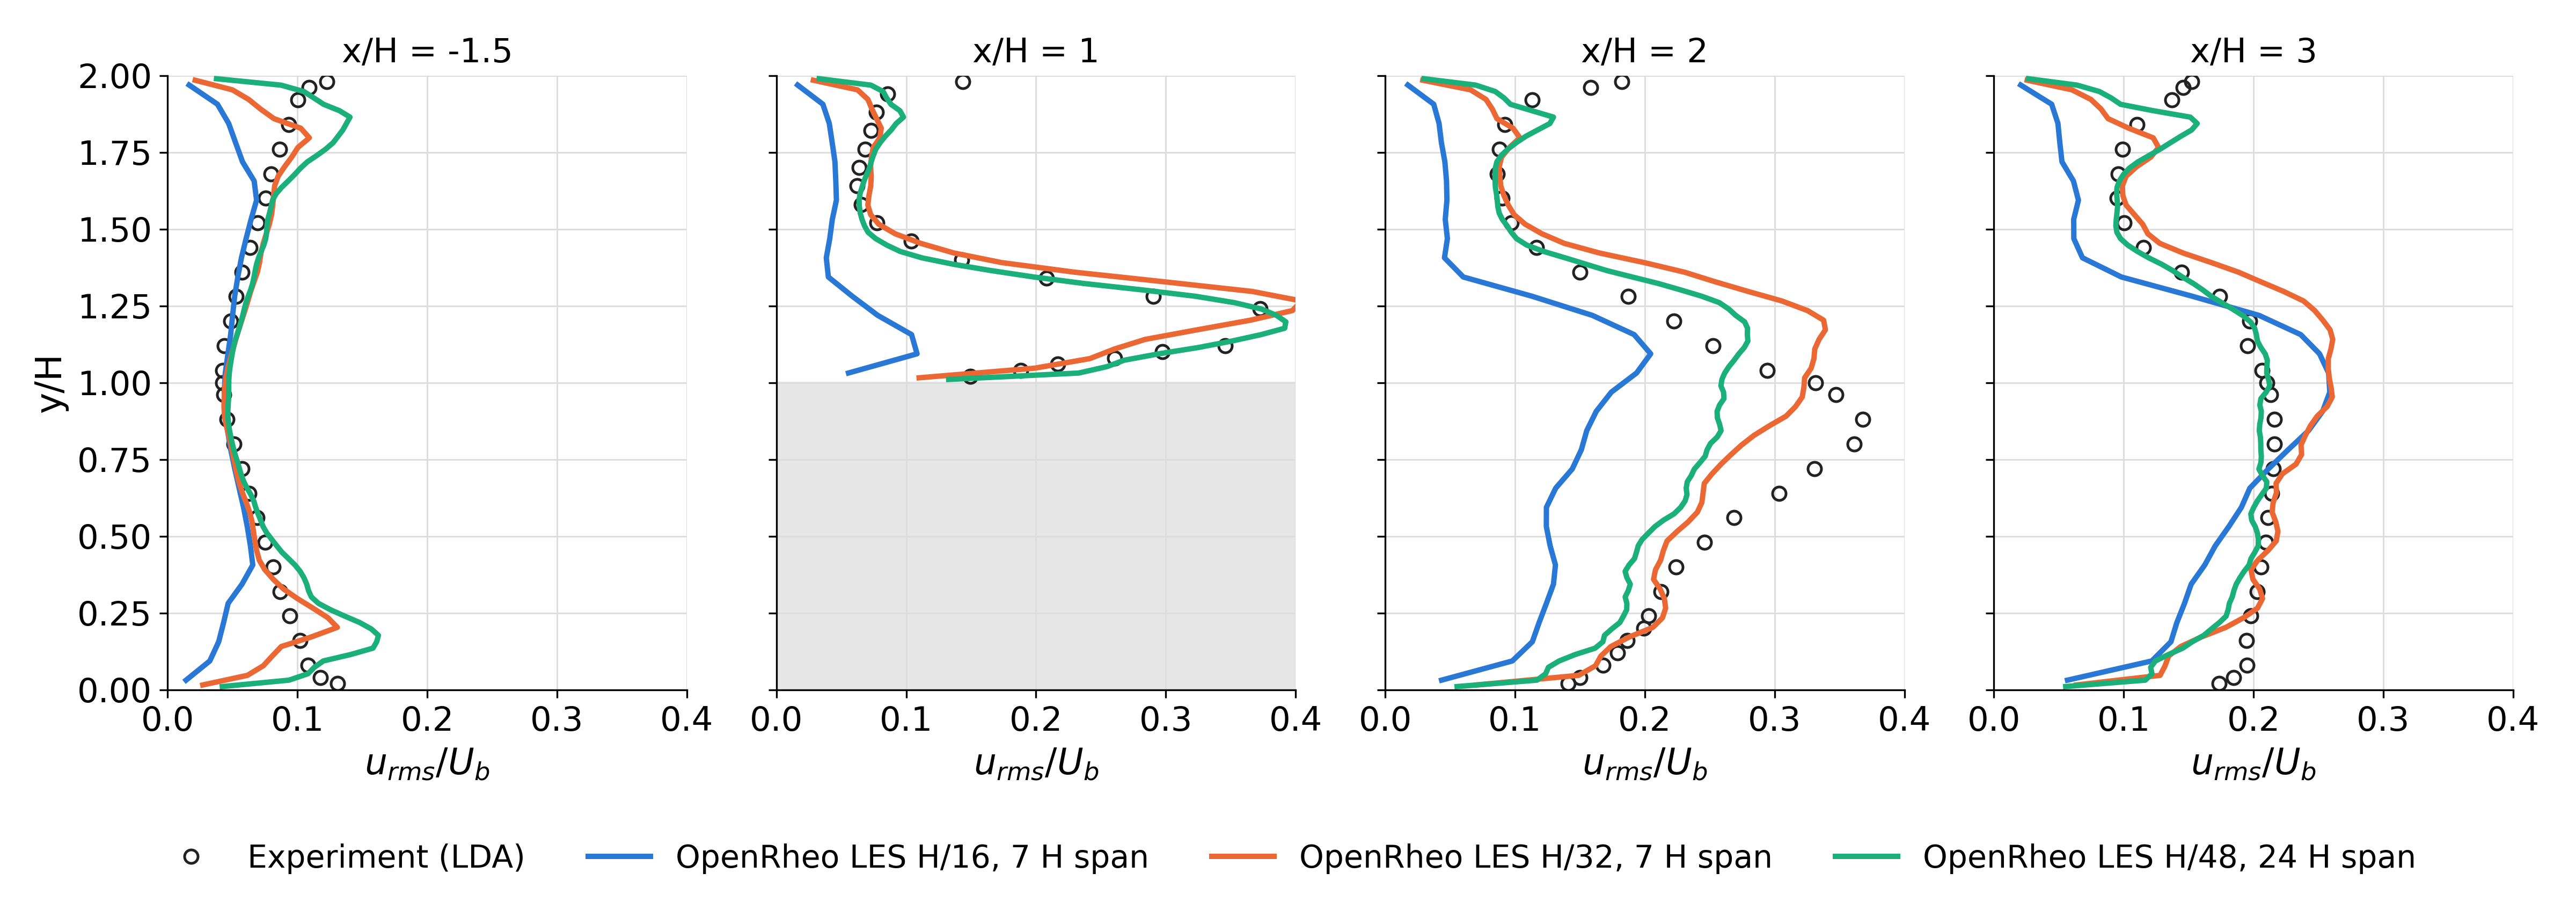
同じ位置の u_rms/U_b。
| 量 | 実験 | H/16 | H/32 | H/48 |
|---|---|---|---|---|
| 後流の再付着長さ X_R/H(最初のセル / y = 0.02H) | 1.62(y = 0.02H) | 2.72 / 2.72 | 1.54 / 1.52 | 1.37 / 1.35 |
| 前面: 最上流の逆流点 x/H(最初のセル) | -1.04(油膜) | -0.83 | -1.10 | -1.14 |
| 屋根: x/H = 0.5 の U/U_b(最初のセル) | -0.56(y = 1.02H) | -0.04 | -0.13 | -0.14 |
| 床から最初のセル中心までの高さ y/H | 0.02(LDA の最下点) | 0.0312 | 0.0156 | 0.0104 |
| U/U_b の平均絶対誤差(全測点) | – | 0.173 | 0.104 | 0.088 |
| u'u'/U_b² の平均絶対誤差 | – | 0.0165 | 0.0097 | 0.0080 |
| v'v'/U_b² の平均絶対誤差 | – | 0.0161 | 0.0063 | 0.0061 |
| u'v'/U_b² の平均絶対誤差 | – | 0.0064 | 0.0036 | 0.0028 |
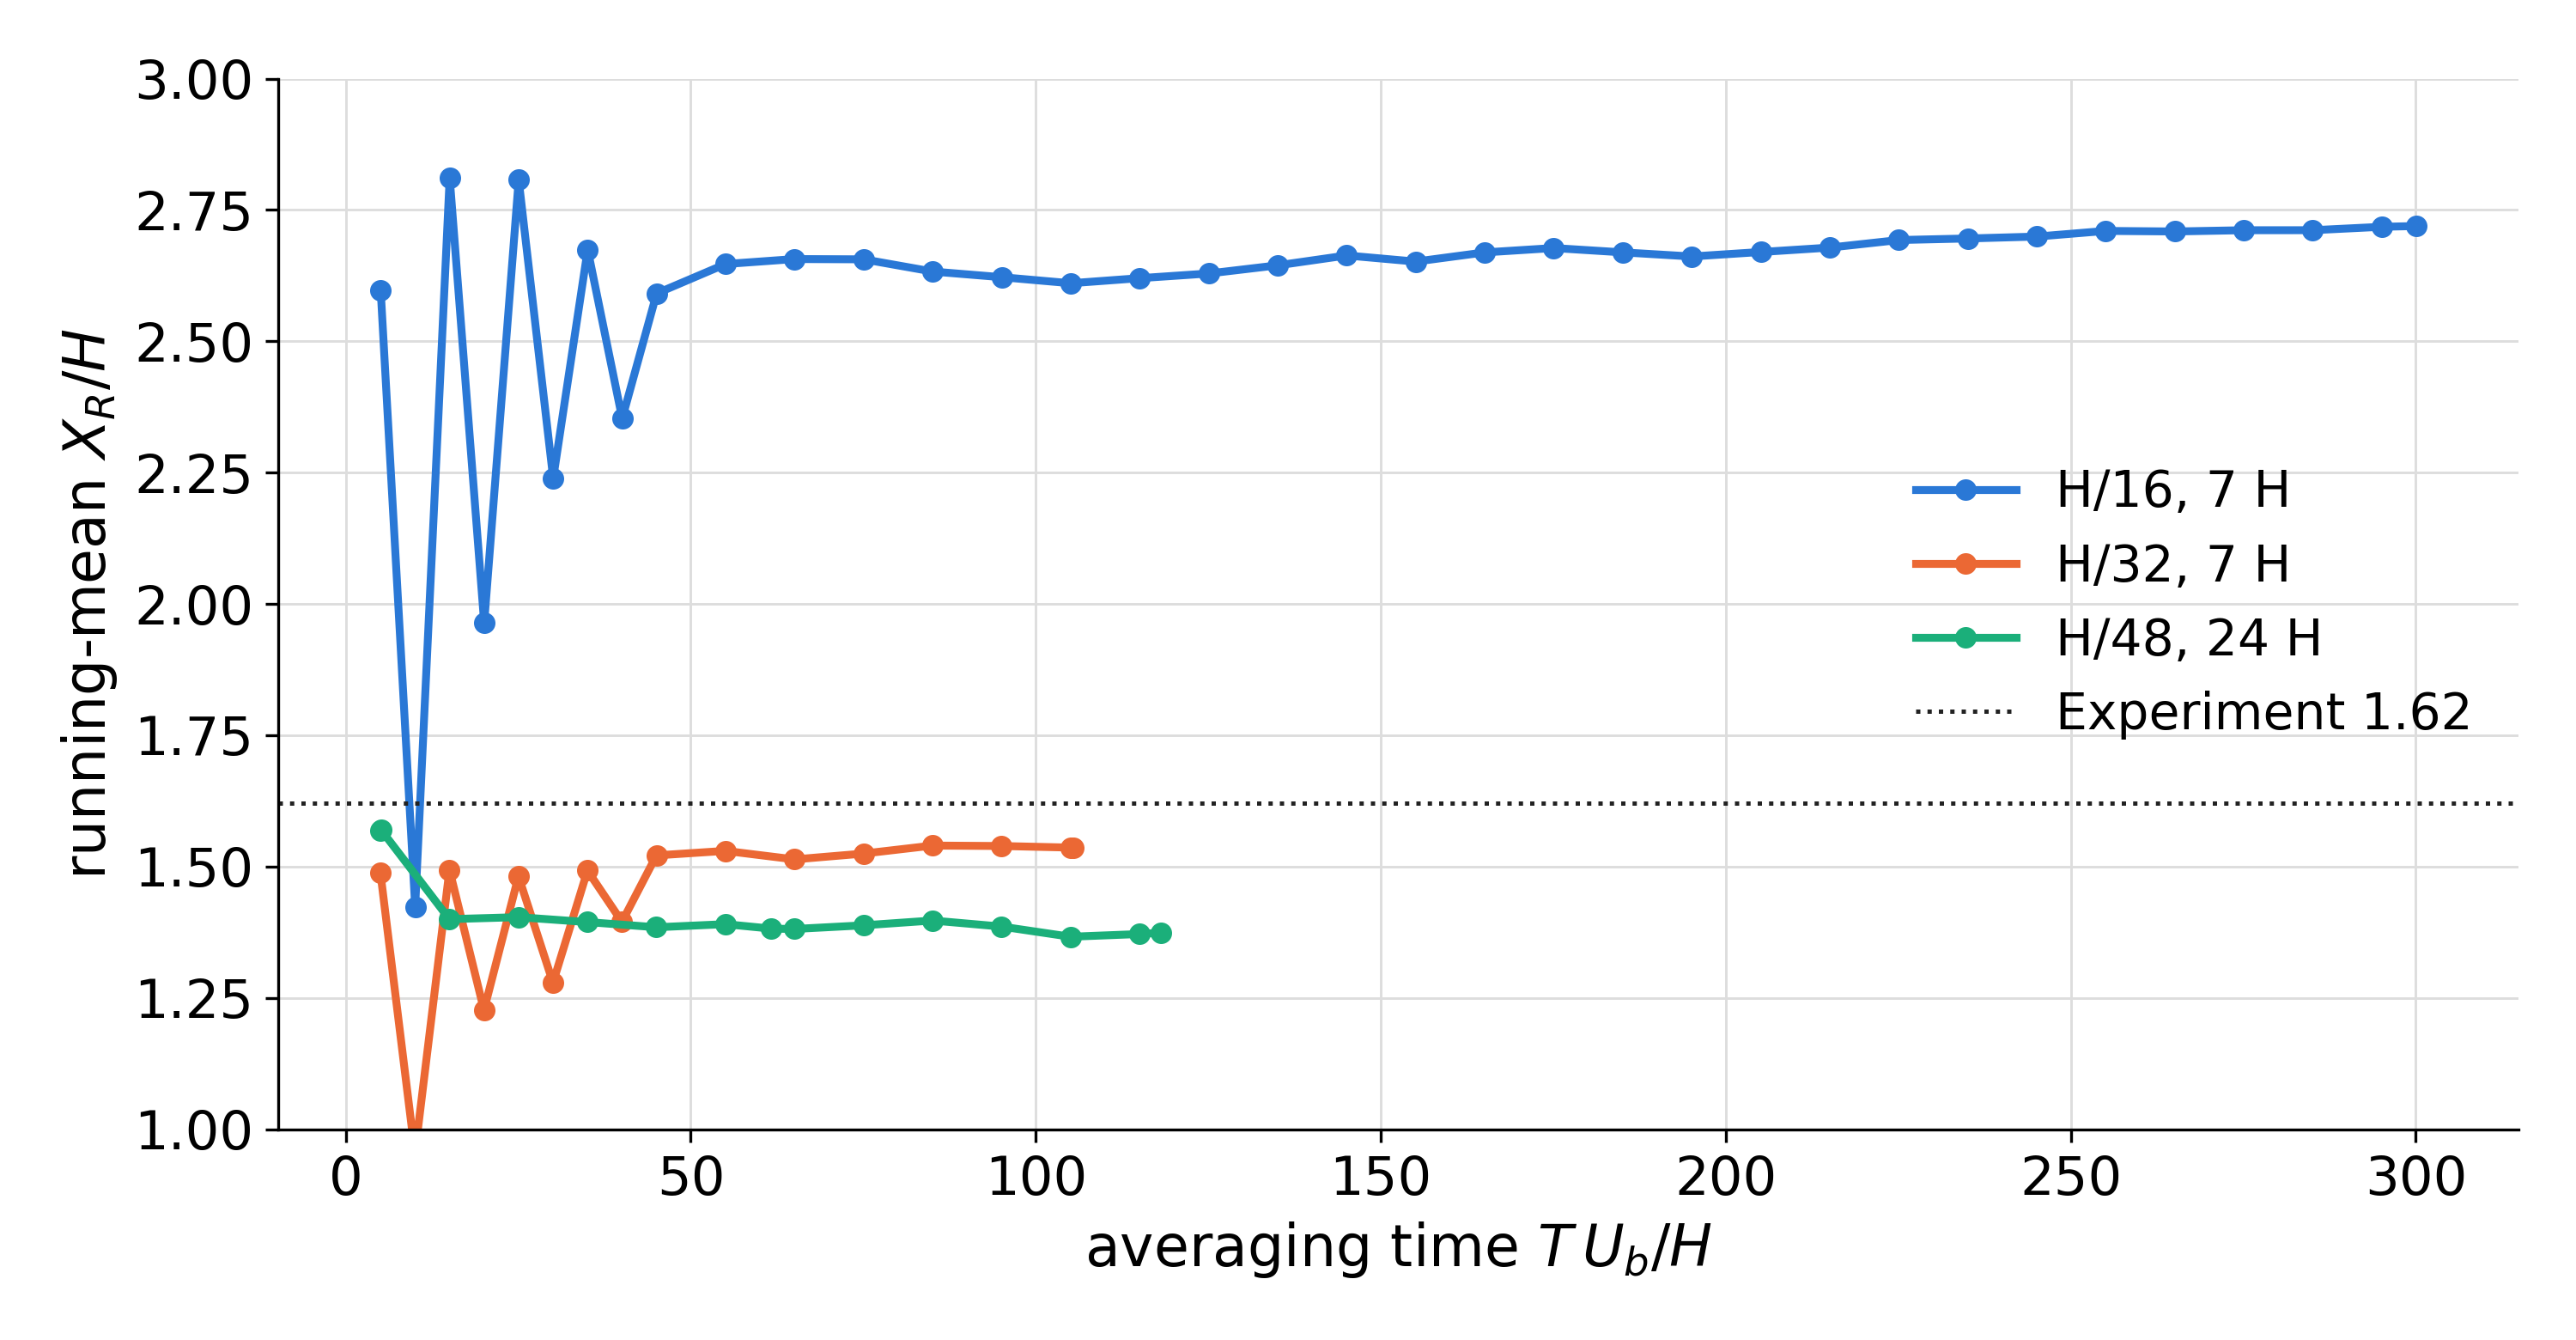
再付着長さ X_R/H(最初のセル)の移動平均と平均時間 T U_b/H。点線は実験(1.62)。最後の 50 H/U_b での変化は H/32 で 0.007H(1.530 → 1.537)、H/48 で 0.009H(1.383 → 1.374)で、X_R は平均時間について収束している。H/16 は 300 H/U_b まで平均しても 2.6〜2.7 にとどまる。
- H/16 から H/32 で誤差の大部分が消え、H/48 で平均速度・応力の誤差はさらに減る。
- X_R は 2.72 → 1.54 → 1.37 と短くなり、H/48 では実験(1.62)より 0.25H 短い。スパンだけを変えた計算(H/32 を 24H、H/48 を 7H、流入の乱数の種を変えて複数本)では、スパン(閉塞率)による X_R の差は種のばらつきの範囲内で、短くなるのは格子の効果。H/64(24H、FP32 計算)でも X_R/H = 1.371 で H/48(1.359 ± 0.038)とばらつきの範囲で一致し、X_R は格子について収束している。
| X_R/H(最初のセル) | スパン 7H | スパン 24H |
|---|---|---|
| H/32 | 1.516 ± 0.025(5 本) | 1.489 ± 0.001(2 本) |
| H/48 | 1.343 ± 0.023(2 本) | 1.359 ± 0.038(5 本) |
| H/64 | – | 1.371(1 本) |
| - 屋根上の逆流は弱いまま(実験 -0.56 に対して -0.14)。 | ||
| - 立方体前方(x/H = -3、-1.5)の壁近くの乱れは、H/32 では実験より小さく、H/48 では約 50 % 大きい。人工乱流の長さスケール(0.3H)が H/48 では 14 セルで解像されて減衰しにくくなったためと考えているが、まだ確かめていない(下の「課題と対策」)。 |
瞬時場(H/48)
H/48 の最後のチェックポイント(t = 163 H/U_b)の瞬時場。
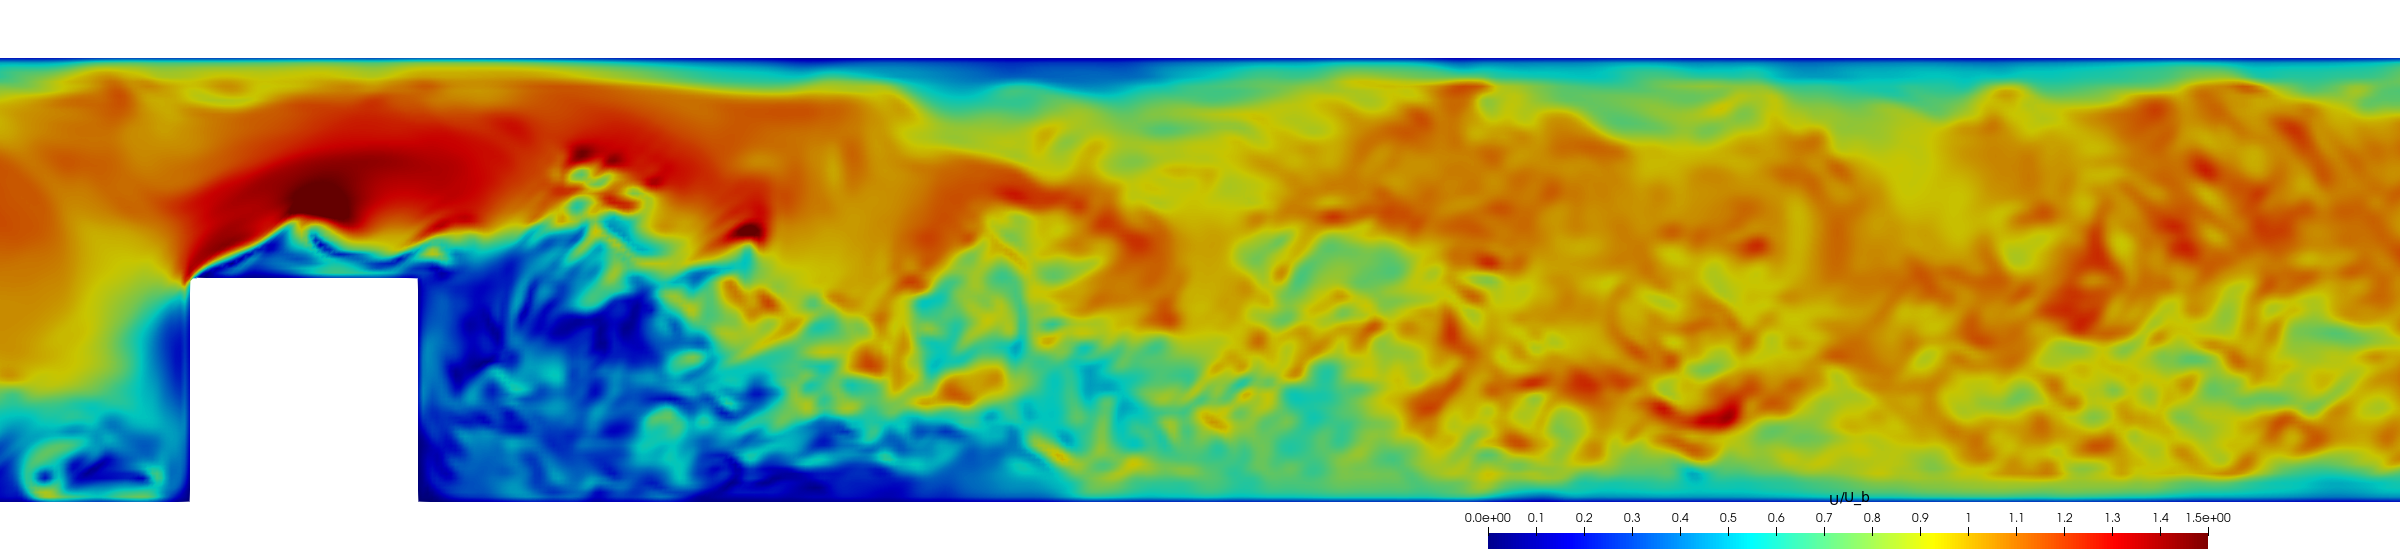
中心面 z = 0 の |U|/U_b(x/H = -3〜12)。
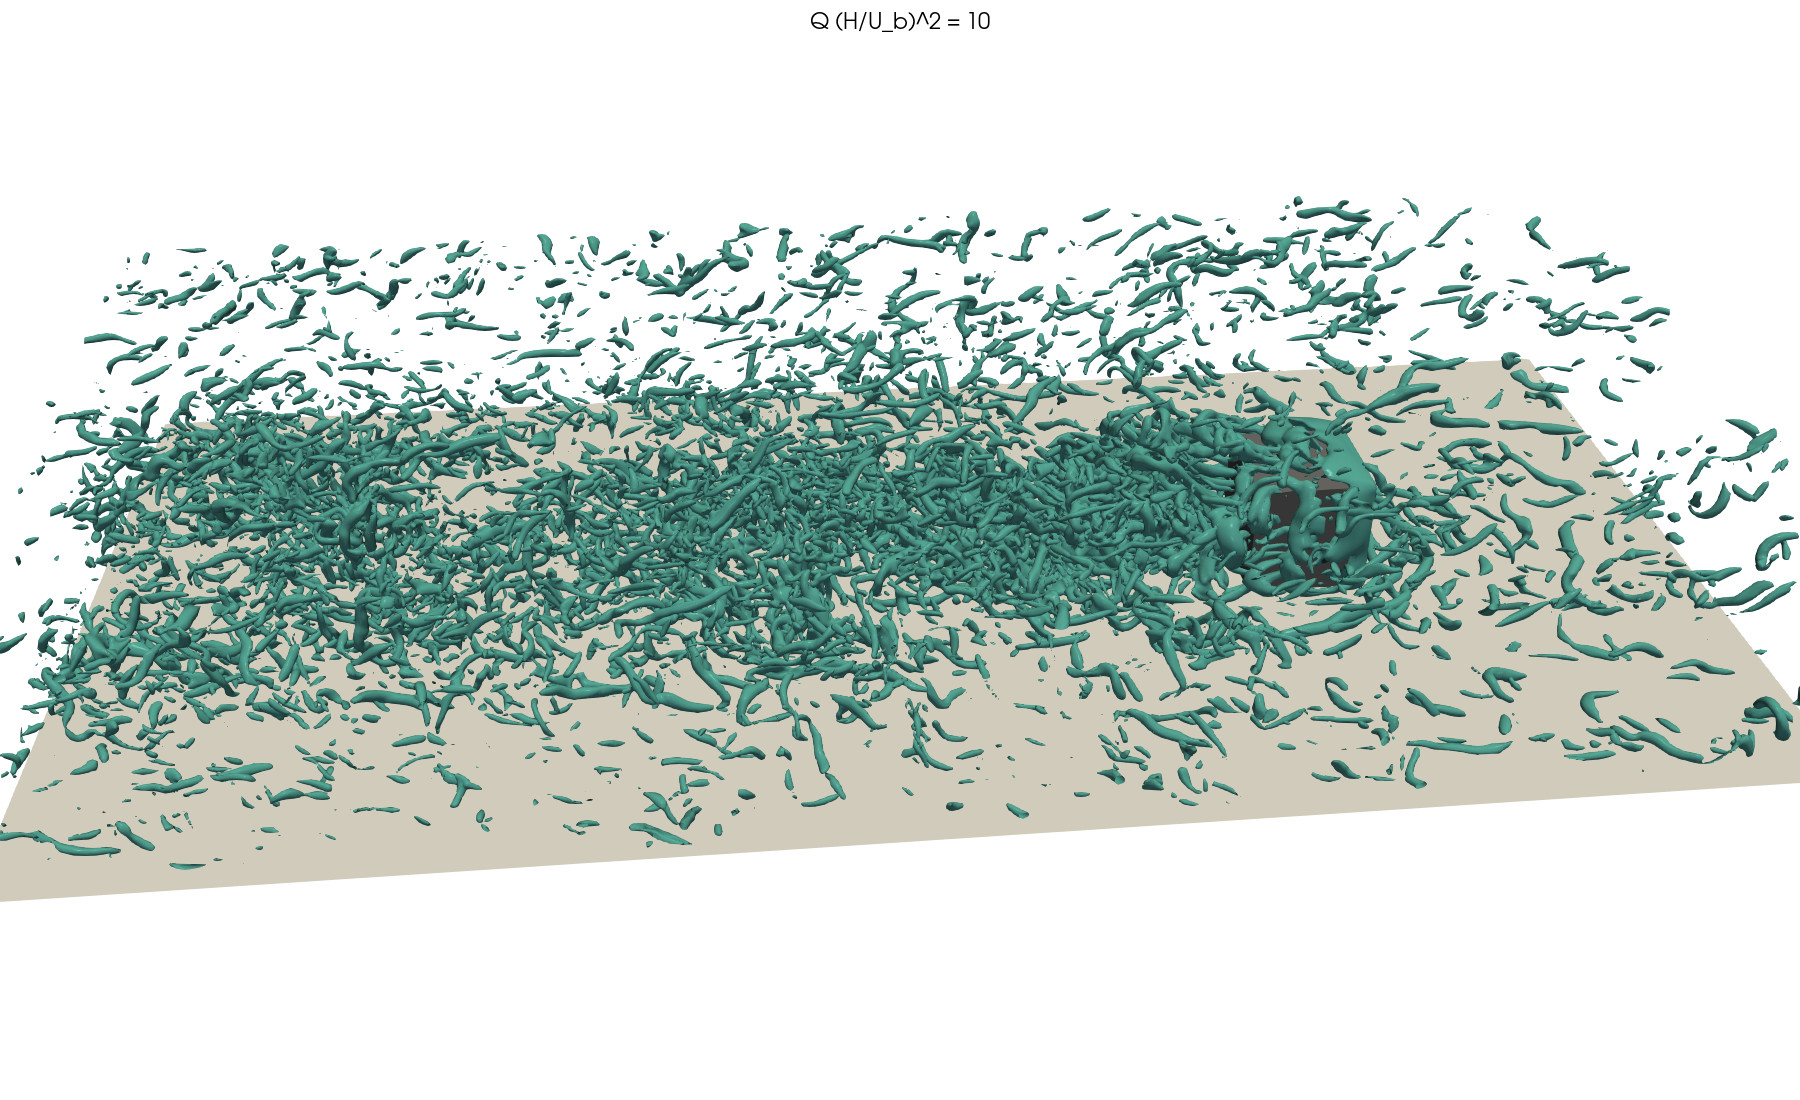
Q (H/U_b)² = 10
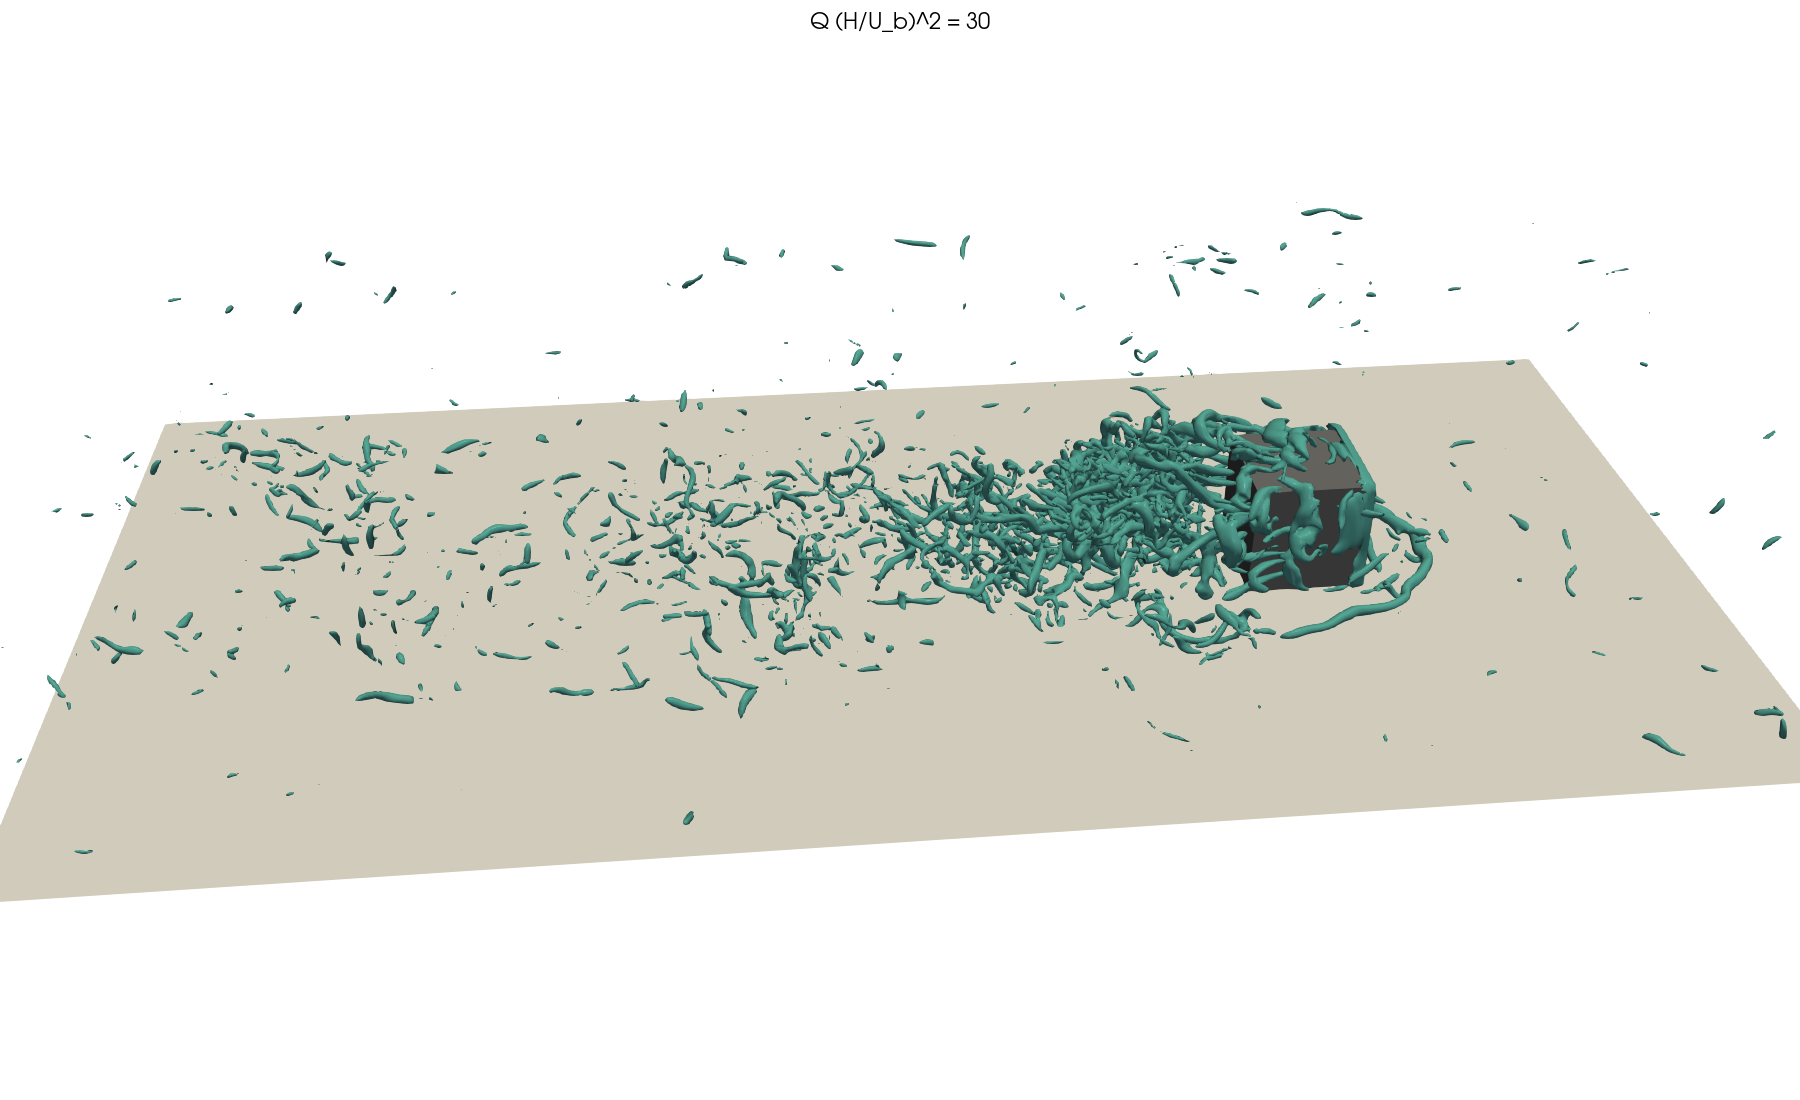
Q (H/U_b)² = 30
Q 値の等値面(Q = ½(|Ω|² − |S|²) を中心差分で計算、壁に接するセルは除く)。上流の渦は流入の人工乱流、上の方の渦は高さ 2H の天井の境界層のもの。Q (H/U_b)² = 30 では、立方体前面の馬蹄渦が側面に回り込む形が見える。
動画(H/48)
最後のチェックポイント(t = 163 H/U_b)から計算を続け、x/H = -3〜11、横方向 ±3.5H の範囲の速度を 48 ステップごとに書き出した 160 コマ(t = 163.2〜171.1 H/U_b、約 10 秒でループ)。
中心面 z = 0 の |U|/U_b(x/H = -3〜11)。
Q (H/U_b)² = 30 の等値面(上の静止画と同じ計算方法、2 セルおきに間引き)。流れは左から右。
文献の計算例(Q 値などの等値面)
| 文献 | 条件 | 等値面 |
|---|---|---|
| Krajnović & Davidson (2002), AIAA J. 40(5), 927–936(doi:10.2514/2.1729) | 本計算と同じ ERCOFTAC case 41(Re = U_b H/ν = 40,000、チャネル高さ 2H、スパン 7H)。LES(動的 1 方程式 SGS)、粗い格子(立方体の各辺に 16〜40 点) | 瞬時の Q = 5(図 9)。立方体側面の横渦(「ティーカップの取っ手」形)の生成と崩壊を示す。正規化は本文に明記なし |
| Nigro et al. (2005), Mecánica Computacional 24, 1299(論文ページ) | ERCOFTAC case 41(Re = U_b H/ν = 40,000、立方体の一辺 1、スパン ±3.5)。有限要素 LES(Smagorinsky、壁関数)、四面体約 130 万、周期チャネルの助走計算で流入 | 瞬時の Q = 0.35(図 21、馬蹄渦・ヘアピン渦・横渦)。時間平均場の Q > 0 を範囲 [0.1, 3.0] と [0.2, 0.5] で表示(図 22)。正規化は本文に明記なし |
| Diaz-Daniel, Laizet & Vassilicos (2017), Int. J. Heat Fluid Flow 68, 269–280(doi:10.1016/j.ijheatfluidflow.2017.09.015、著者版 PDF) | DNS、境界層(層流・乱流)中の立方体、Re_H = U∞H/ν = 500〜3,000 | 層流境界層の図 3 で、Q H²/U∞² = 0.1(Re_H = 500、600、750)、0.2(1,100)、0.28(1,700、3,000)。Re_H = 500 では 0.003 まで下げて弱い非定常構造を示す。流れ方向速度で色付け。立方体上面から周期的に出るヘアピン渦 |
| Schröder et al. (2020), Exp. Fluids 61, 189(doi、オープンアクセス) | 実験(時間分解 PIV、3D Shake-The-Box)と LBM(ProLB)、境界層中の立方体、Re_H = 2,000〜8,000 | Q ではなく渦度の大きさの等値面(層流流入の例で |ω| = 170 s⁻¹) |
- 本計算に条件が最も近いのは上の 2 件(同じ case 41 の LES)で、しきい値は Q = 5 と 0.35。このページの Q (H/U_b)² = 10、30 はそれより大きい。格子が細かいほど小さく強い渦まで解像されるので、一般に同じように見せるためのしきい値は大きくなる(このページの H/48 は立方体の一辺に 48 セル、Krajnović & Davidson は 16〜40 点)。
- Q のしきい値は、レイノルズ数、格子解像度、正規化に使う速度(上の文献は自由流速 U∞、このページは bulk 速度 U_b)で大きく変わる。このページの Q (H/U_b)² = 10、30 は Re_H = 40,000 の LES で、上の DNS(Re_H ≤ 3,000)の値とは直接比べられない。しきい値は、構造が見分けられる値を計算ごとに選んでいる。
速度とスケーリング(Miyabi-G、GH200)
1 ノードに GH200 が 1 台、1 GPU に 1 MPI ランク。D3Q27、FP64。
| 計算 | GPU | s/step | MLUPS | 効率 T₁/(N T_N) |
|---|---|---|---|---|
| H/48(1.23 億セル) | 1 | 0.1953 | 631 | 100 % |
| 2 | 0.0997 | 1,237 | 98 % | |
| 4 | 0.0542 | 2,273 | 90 % | |
| 8 | 0.0289 | 4,266 | 84 % | |
| H/32(1,010 万セル) | 1 | 0.0166 | 607 | 100 % |
| 2 | 0.0088 | 1,151 | 95 % | |
| 4 | 0.0051 | 1,990 | 82 % | |
| 8 | 0.0032 | 3,188 | 66 % |
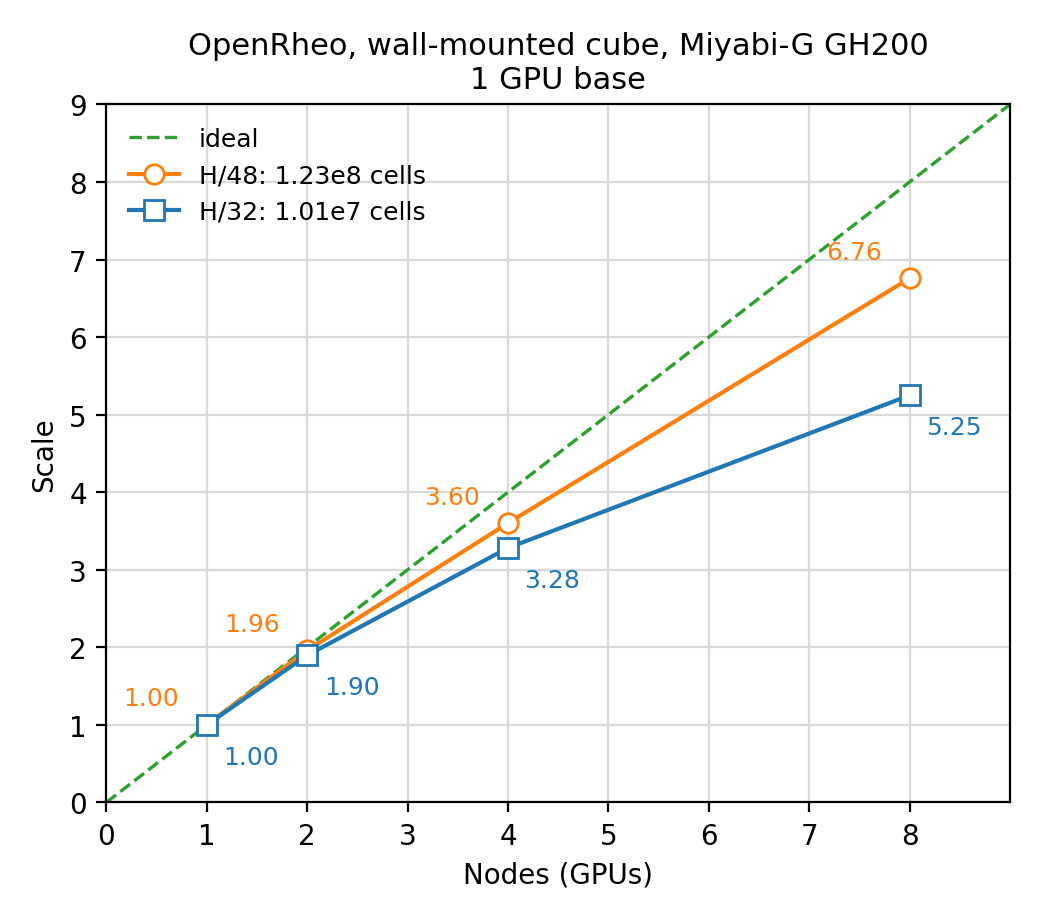
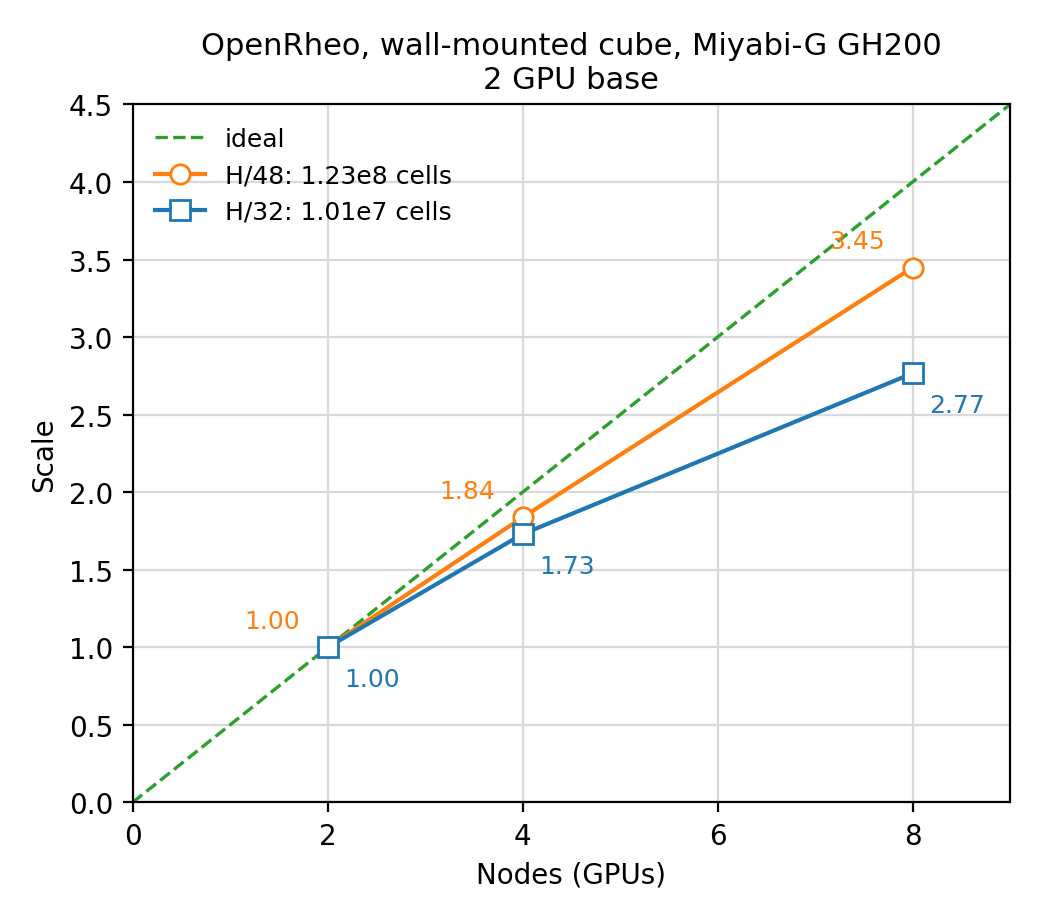
| 1 GPU 基準 | 2 GPU 基準 |
|---|---|
 |
 |
- カーネル部分は 1→8 GPU でほぼ理想的に縮み、効率の低下は halo 交換(パック、MPI、アンパック)の時間による。
- 改良版(受け手が読む方向の分布関数だけを送る、壁の ghost の交換を省く、内側ブロックの衝突と局所コピーを MPI と重ねる)では、8 GPU で H/48 が 0.0263 s/step(4,686 MLUPS、効率 93 %)、H/32 が 0.0025 s/step(4,040 MLUPS、83 %)になった。結果は改良前とビット単位で一致する。2 GPU と 4 GPU の改良版は測定待ちで、上の図と表は改良前の値。
- 1 GPU あたり 6.2 × 10⁷ セルの弱スケーリング(1→2 GPU)は 100 %。
- オープンCAEシンポジウム2026 の発表では、上の表の H/48(1.23 億セル、固体帯込み)の速度向上率を、1 GPU 基準で 2/4/8 GPU で 1.96/3.60/6.76 倍(並列化効率 98.0/90.0/84.5 %)と示した。
- H/48 の本計算(統計の FP64 積算つき)は 8 GPU で 0.0277 s/step(約 4,450 MLUPS)、156,600 ステップで約 1 時間 15 分(約 10 ノード時間)。
速度とスケーリング(Flow2、GB200)
名古屋大学の Flow2(不老・弍)Type II は 1 ノードに GB200 が 4 基。1 ノード内の 1、2、4 GPU で、halo 交換の 3 通りを比べた。1 GPU に 1 MPI ランク、D3Q27、FP64。
| 計算 | GPU | 従来版 s/step(効率) | 送る量を減らす版 | 計算と重ねる版 |
|---|---|---|---|---|
| H/48(1.23 億セル) | 1 | 0.1664(741 MLUPS) | – | – |
| 2 | 0.0835(99.7 %) | 0.0837(99.5 %) | 0.0837(99.4 %) | |
| 4 | 0.0444(93.8 %) | 0.0440(94.6 %) | 0.0433(96.2 %) | |
| H/32(1,010 万セル) | 1 | 0.01443(699 MLUPS) | – | – |
| 2 | 0.00747(96.6 %) | 0.00738(97.8 %) | 0.00751(96.1 %) | |
| 4 | 0.00407(88.6 %) | 0.00387(93.2 %) | 0.00402(89.7 %) |
- 「送る量を減らす版」は受け手が読む方向の分布関数だけを送り、壁の ghost の交換を省く。「計算と重ねる版」はさらに内側ブロックの衝突と局所コピーを MPI と重ねる。
- 1 GPU では GB200 が GH200(Miyabi-G)より約 17 % 速い(H/48 で 0.166 対 0.195 s/step)。
- 4 GPU の従来版の効率は H/48 で 94 %、H/32 で 89 % で、Miyabi-G(90 %、82 %、GPU 間はノード間通信)より高い。4 GPU がノード内でつながっているため、H/48 の halo 交換は Miyabi-G の 6.3 ms に対し 3.4 ms(計算と重ねる版で 2.0 ms)。このため改良の効果は 1〜2 ポイントにとどまる。
- 分布関数のチェックサムは、3 通りの交換のすべてで同じで、Miyabi-G(GH200)の値とも一致する(計算機をまたいでビット単位で同じ結果)。
- 2 ノード(8 GPU)は測定待ち(Flow2 Type II の複数ノードジョブはまだ流れていない)。
速度とスケーリング(Aquarius、A100)
東京大学 Wisteria/BDEC-01 の Aquarius(1 ノードに A100-SXM4-40GB が 8 基)。1 GPU に 1 MPI ランク、NVHPC 25.9 と付属の HPC-X(CUDA 対応)、stdpar 版。各行は 3 通りの halo 交換のうち最速のもの。
| 計算 | GPU(ノード) | s/step | MLUPS | 効率 |
|---|---|---|---|---|
| H/32 | 1 | 0.0305 | 331 | 100 % |
| 2 | 0.0156 | 647 | 98 % | |
| 4 | 0.0082 | 1,226 | 93 % | |
| 8(1) | 0.0045 | 2,240 | 85 % | |
| 16(2) | 0.0027 | 3,767 | 71 % | |
| 32(4) | 0.0019 | 5,423 | 51 % | |
| H/48 | 4 | 0.0993 | 1,241 | 100 %(4 GPU 基準) |
| 8(1) | 0.0536 | 2,302 | 95 % | |
| 16(2) | 0.0285 | 4,322 | 89 % | |
| 32(4) | 0.0156 | 7,912 | 80 % |
- A100 1 基は GH200・GB200 の約 0.45〜0.5 倍。H/48 は 40 GB の GPU 1〜2 基には入らない。
- 2 ノードでは送る量を減らす交換が効き、H/48 の効率は従来の交換の 74 % に対し 89 %。計算と重ねる効果は 2 % 以内。
- チェックサムは Miyabi-G・Flow2 と一致する(4 ノードを含む)。4 ノード(32 GPU)の効率は H/32 で 51 %、H/48 で 80 %。8 ノードは測定していない。
1 ノードで解ける大きさ(Flow2、GB200 4 基)
スパン 24H のまま格子を細かくした。計算と重ねる交換、100 ステップ。
| 格子 | セル数 | s/step | MLUPS | ホストメモリの最大(1 ランク) |
|---|---|---|---|---|
| H/48 | 1.23 億 | 0.0433 | 2,849 | – |
| H/64 | 2.83 億 | 0.1001 | 2,823 | 68〜70 GB |
| H/72 | 4.01 億 | 0.1422 | 2,823 | 94〜98 GB |
| H/80 | 5.50 億 | 0.1902 | 2,890 | 127〜130 GB |
| H/88 | 7.31 億 | 0.2546 | 2,869 | 167〜171 GB |
- 大きくしても GPU 1 基あたり約 710 MLUPS で落ちない。1 ランクのホストメモリは担当セル 1 個あたり約 930 B で、ジョブの上限(864 GB)から 1 ノードは H/88 程度まで。
CUDA 版
衝突と並進を 1 つの CUDA カーネルにまとめ、ブロック間のコピーを隣のブロックからの直接読み出しに置き換えた版。さらに、分布関数を内部のセルだけの配置(16 セルの行を 128 バイト境界にそろえる)にし、床と天井のセルを専用のカーネルにした(LBM_CUDA=3)。演算の順序は stdpar 版と同じで、分布関数のチェックサムは GB200・A100 の 1〜8 GPU で stdpar 版とビット単位で一致する。s/step(かっこ内は stdpar 版との比)。
| GB200 | stdpar | CUDA(はじめの版) | CUDA(配置変更) | 配置変更 + FP32 保存 | 配置変更 + FP32 計算 |
|---|---|---|---|---|---|
| H/48、1 GPU | 0.1664 | 0.0292(5.7 倍) | 0.0222(7.5 倍) | 0.0228 | 0.0178(9.4 倍) |
| H/48、4 GPU | 0.0433 | 0.00846(5.1 倍) | 0.00656(6.6 倍) | 0.00671 | 0.00545(7.9 倍) |
| H/32、1 GPU | 0.01442 | 0.00271(5.3 倍) | 0.00195(7.4 倍) | 0.00201 | 0.00156(9.2 倍) |
| H/32、4 GPU | 0.00404 | 0.00092(4.4 倍) | 0.00069(5.9 倍) | 0.00071 | 0.00059(6.8 倍) |
| A100 | stdpar | CUDA(はじめの版) | CUDA(配置変更) | 配置変更 + FP32 計算 |
|---|---|---|---|---|
| H/32、1 GPU | 0.0305 | 0.00693 | 0.00516(5.9 倍) | 0.00402 |
| H/32、4 GPU | 0.00823 | 0.00222 | 0.00176(4.7 倍) | 0.00149 |
| H/32、8 GPU | 0.00450 | 0.00148 | 0.00118(3.8 倍) | 0.00101 |
| H/48、4 GPU | 0.1004 | 0.0289 | 0.0244(4.1 倍) | 0.0208 |
| H/48、8 GPU | 0.0538 | 0.0194 | 0.0165(3.3 倍) | 0.0145 |
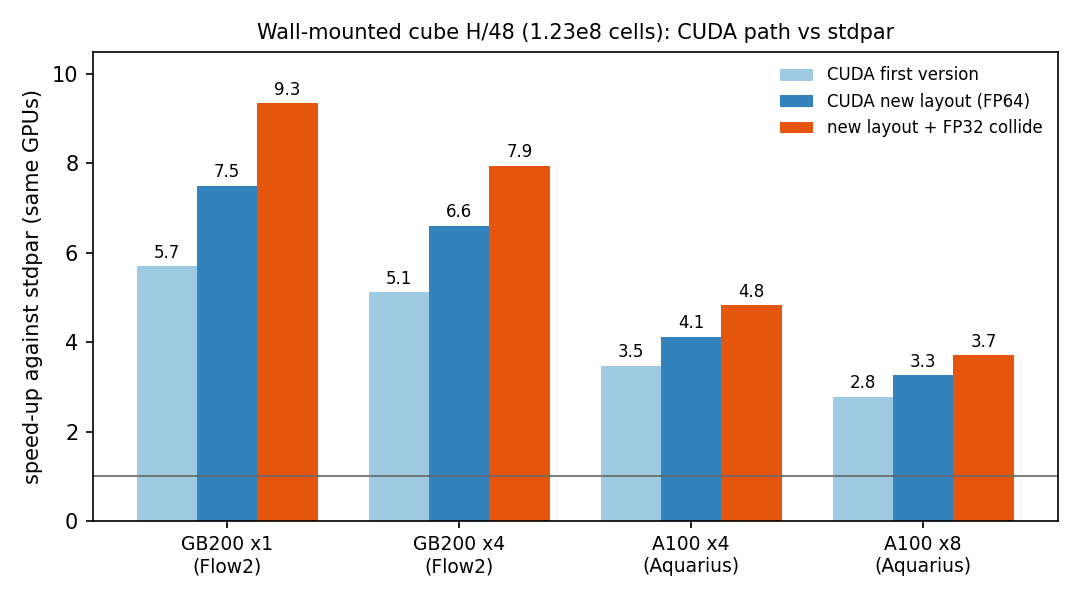
同じ GPU での、stdpar 版に対する CUDA 版の速度向上(H/48、力の出力を含む s/step)。
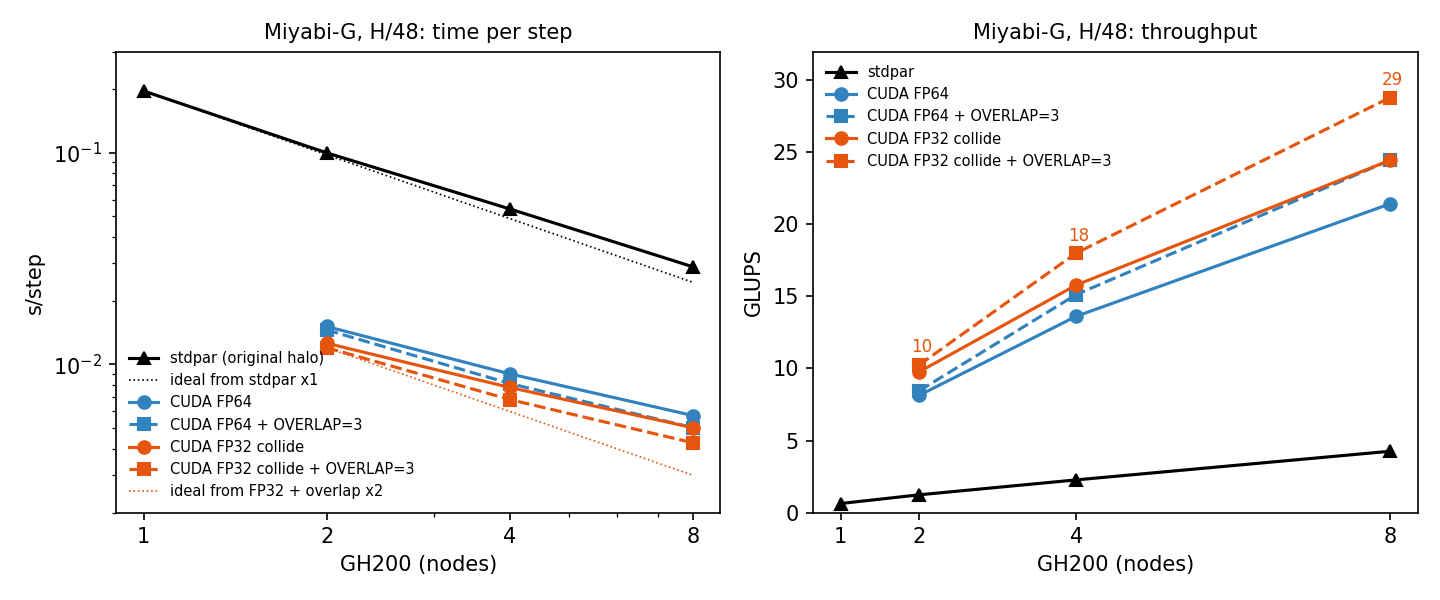
Miyabi-G での H/48 の強スケーリング(1 ノードに GH200 1 基、2026-10-29)。左は 1 ステップの時間(点線は理想)、右は処理速度。CUDA 版は 2 ノードから測った(1 ノードでは、H/48 が準備の段階で Miyabi-G のジョブのメモリ上限 100 GiB(GPU のメモリを含む)を超えて止められる)。GH200 8 基で、FP32 衝突と OVERLAP=3 を使うと 29 GLUPS で、元の halo 交換の stdpar 版の 6.8 倍である。
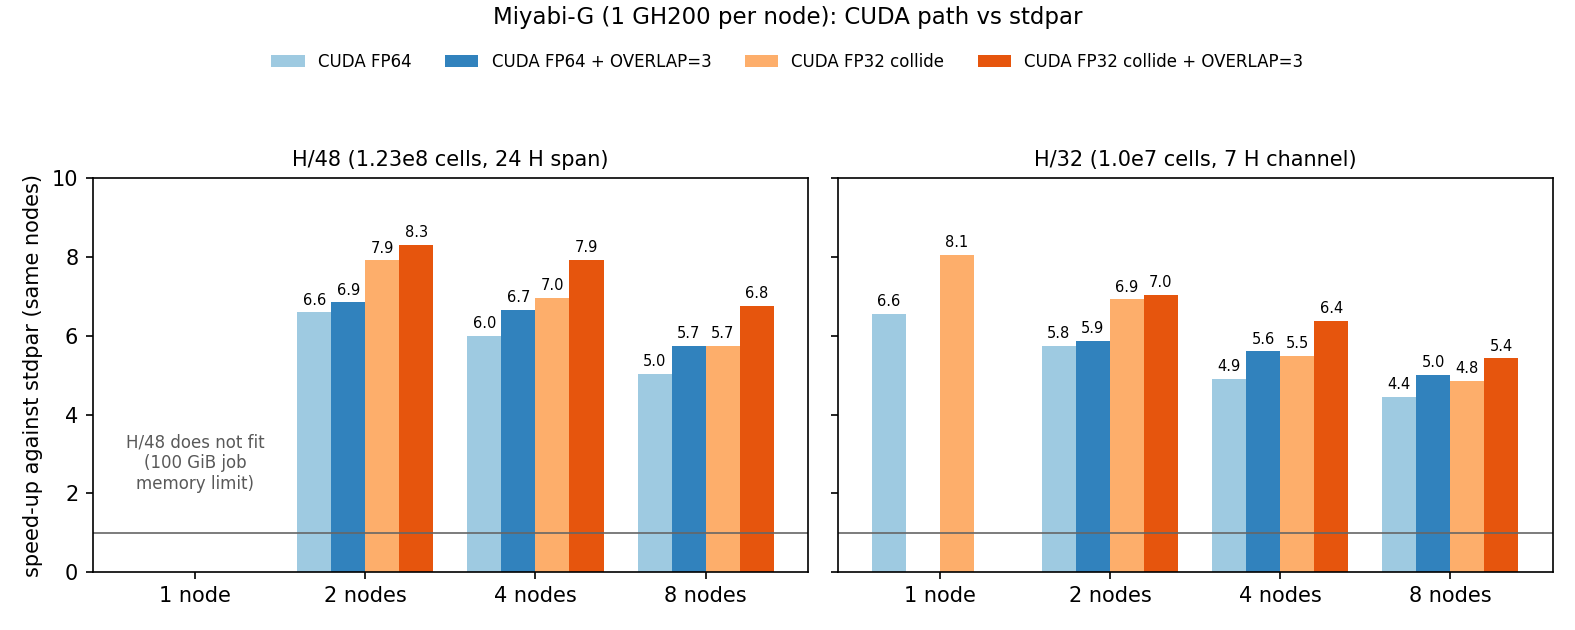
Miyabi-G(1 ノードに GH200 1 基)での、同じノード数の stdpar 版に対する CUDA 版の速度向上(力の出力を含む s/step。stdpar は元の halo 交換、CUDA は 2026-10-29)。FP32 衝突と OVERLAP=3 で、H/48 は 2 / 4 / 8 ノードで 8.3 / 7.9 / 6.8 倍速い。ノード数が増えると速度向上は下がる(原因はまだ測っていない)。H/48 は 1 ノードには載らない(ジョブのメモリ上限)。
- FP32 保存:分布関数を f − wᵢ の形の FP32 で保存し、計算は FP64。FP32 計算:衝突も FP32。統計とチェックポイントは FP64 のまま。
- 非同期の読み込み(cp.async)と 2 ストリームは試したが速くならなかった。
- 力の計算(ホストでの集計)を除いたカーネルだけの時間では、H/48 で GB200 1 基が FP64 で 0.01925 s/step(stdpar の 8.5 倍)、FP32 計算で 0.01485 s/step(11.0 倍)、4 基で 0.00510 / 0.00399 s/step(8.4 / 10.7 倍)。
- カーネルはメモリ帯域でも FP64 演算でもなく待ち時間で律速している。FMA をまとめない版(6〜8 % 速いだけ)と、計算と MPI を重ねる版(1 ノード内では速くならない)は既定にしていない。
FP32 の検証
H/32 の本計算(45 H/U_b の助走 + 105 H/U_b の平均)を、流入の乱数の種を変えて各 5 本。± は種の間の標準偏差。
| 版 | X_R/H(最初のセル) | x_F/H | U の平均絶対誤差 | u'v' の平均絶対誤差 |
|---|---|---|---|---|
| FP64 | 1.516 ± 0.025 | −1.111 ± 0.017 | 0.1032 | 0.0039 |
| FP32 保存 | 1.511 ± 0.017 | −1.111 ± 0.018 | 0.1029 | 0.0038 |
| FP32 計算 | 1.499 ± 0.029 | −1.111 ± 0.018 | 0.1033 | 0.0039 |
| H/48 FP64(45 + 60 H/U_b) | 1.359 ± 0.038 | – | 0.0875 | 0.0029 |
| H/48 FP32 計算 | 1.368 ± 0.058 | – | 0.0871 | 0.0030 |
- FP32 計算の X_R は FP64 より 0.017 短いだけで、差の標準誤差と同程度。有意なずれはない(1 本ずつの比較で見えた 0.05〜0.07 は種によるばらつきだった)。誤差の指標は 3 桁目まで一致する。
- 検証済みの最速の構成は、配置変更 + FP32 計算(GB200 1 基の H/48 で stdpar の 9.4 倍)。H/48(45 H/U_b の助走 + 60 H/U_b の平均、各 5 本)でも FP32 計算による差は種のばらつきの範囲内。4 基の GB200 の本計算モードの H/48 は FP64 で 0.0052 s/step(24 GLUPS)、FP32 計算で 0.0040 s/step(30 GLUPS)。
- H/48 を FP32 計算で 45 + 118 H/U_b 回した結果は FP64 と許容差内で一致した(X_R/H 1.390 対 1.374、U の平均絶対誤差 0.0863 対 0.088)。このため、本計算は配置変更 + FP32 計算(
LBM_CUDA=3 LBM_FP32=2)を標準とし、FP64 の配置変更版は stdpar との照合用に残す。H/64(2.8 億セル)の本計算は GB200 4 基で 0.0088 s/step、192,000 ステップを 1 時間で回せる。
課題と対策
立方体前方の壁近くの乱れ
現状: y = 0.15H での u_rms/U_b は次のとおり。H/48 のピークは y = 0.14〜0.18H にあり、実験のピークは最下点(0.02H)にある。天井(y = 2H)近くでも同じように大きすぎる。
| x/H | 実験 | H/32 | H/48 |
|---|---|---|---|
| -3 | 0.094 | 0.084 | 0.135 |
| -1.5 | 0.103 | 0.094 | 0.160 |
流入の作り方: x/H = -18 で測った平均速度とレイノルズ応力を、壁で 0 になるように流入口(x/H = -10)に与え、デジタルフィルタで変動を作る。フィルタの長さスケールは高さ方向に一定(L_y = L_z = 0.3H、時間相関 L_x = 1.0H)。助走計算やリサイクルはないので、流入口から x/H = -3 までの 7H で、人工乱流が壁乱流として発達するかどうかで結果が決まる。
原因の候補(どれもまだ確かめていない):
- 長さスケールが壁近くでも 0.3H のままで、壁乱流の渦(壁からの距離に比例して小さい)より大きい。H/48 ではこれが 14 セルで解像され、減衰せずに下流へ運ばれる(H/32 では 10 セルで、より早く減衰する)。
- 流入口での振幅そのもの。実験の応力を Cholesky 分解で与えているが、格子で解像できない成分まで与えている可能性がある。
- 壁関数つき LES の壁近くの u_rms の過大評価。壁関数を使う LES では、最初の数セルで流れ方向の変動が大きく出ることがある。
対策(順に):
- 切り分けの測定: x/H = -9.5、-8、-6、-3 の断面で u_rms の高さ分布を出し、流入口での値と下流での減衰・増幅を分ける。流入口で既に大きければ 2、下流で増えるなら 3、流入口では合っていて減衰が遅いだけなら 1。いまの出力は y/z 断面だけなので、x 断面の出力を足す。
- 壁からの距離に応じた長さスケール: L_y、L_z を壁近くで min(0.3H, κ d)(d は壁からの距離、κ ≈ 0.41)程度に小さくする。格子に依存しないように、セル数でなく H 単位で決める。H/32 と H/48 の両方で、x/H = -3、-1.5 の u_rms が実験に近づくかを見る。
- 助走区間で流入を作る: 周期境界のチャネル流(同じ格子幅)を別に回し、その断面を流入に使う(precursor)。いちばん確実だが、断面の時系列の入出力が新たに要る。
- 流入口の位置: 流入口を上流に離す(-10H → -15H など)と、人工乱流が発達する距離が延びる。1 の測定で減衰が遅いことがわかった場合に、2 と比べる。
その他
X_R の差について、格子の効果とスパン(閉塞率)の効果を分ける:済み(スパンの効果は種のばらつきの範囲内、短くなるのは格子の効果、H/64 で収束)。実験より短い原因は残る。- スパン方向の周期境界と側面の no-slip 境界の選択肢(いまは H/48 の側壁を固体セルの帯で作っている)。
- 計算の準備(トポロジー、分割)がホスト側で 1 ジョブ 1.5〜2 × 10⁸ セル程度に制限している。
Miyabi-G でのビルドと実行
2026-10-29 に、公開版の main(スクリプトは scripts/case041/miyabi/)と nvhpc 25.9 + HPC-X 25.9 で確かめた。Miyabi-G は 1 ノードに GH200 が 1 基なので、1 ノードに 1 MPI ランクで動かす。ジョブのメモリ上限(100 GiB)には、GPU のメモリに置いた分も数えられる。
1. ソースと流入データ
ログインノード。
export GROUP=<グループ>                                # 課題のグループ(例 gz00。id -Gn で所属を確認)
export CASE_DIR=/work/$GROUP/$USER/case041             # このケースの作業ディレクトリ
git clone https://gitlab.com/masaz/openrheo.git && cd openrheo
scripts/case041/fetch_data.sh                          # ERCOFTAC case 41 のデータ(リポジトリには含まない)
mkdir -p $CASE_DIR/bin && python3 scripts/case041/make_inflow.py $CASE_DIR/inflow_x01.dat
/work は課題のグループごとに分かれているので、グループは明示する。Miyabi では id -gn が課題のグループではなく個人のグループを返す。
2. ビルド
計算ノードで約 2 分。scripts/case041/miyabi/build.pbs が 1 GPU 用と複数 GPU 用の計算プログラムをビルドする。CUDA=1 を付けると、CUDA 版(-cuda)の複数 GPU 用 orheo-forest-cube-channel-d3q27-mpi-cuda もビルドする。
qsub -W group_list=$GROUP -v REPO=$PWD,BIN_DIR=$CASE_DIR/bin,CUDA=1 scripts/case041/miyabi/build.pbs
ビルドのログは、qsub を実行したディレクトリにできるジョブの出力 c41-build.o<ジョブ番号>(速度の確認は c41-speed.o<ジョブ番号>)。コンパイラは 30 個ほどの警告(ラムダの捕捉、カーネルの起動)を出すが、問題ない。成功すれば最後の行が === build done、失敗すれば === build FAILED か === CUDA build FAILED になる。grep -v -i warning c41-build.o* | grep -E "===|error" で、それだけを表示できる。
3. 速度とチェックサムの確認
scripts/case041/miyabi/run_speed.pbs。ノード数は select で指定し、1 ノード 1 ランク。H/48(スパン 24 H、20 + 200 ステップ)と H/32(7 H のチャネル、20 + 400 ステップ)を、5 つの設定で流す:stdpar の元の halo 交換、stdpar の縮小 halo 交換+重ね合わせ、CUDA FP64、CUDA FP64+OVERLAP=3、CUDA FP32 衝突+OVERLAP=3。ほかの設定は MODES で指定する(スクリプトの先頭を参照)。2 ノードで、ジョブ全体は約 4 分。
qsub -W group_list=$GROUP -l select=2 -v CASE_DIR=$CASE_DIR scripts/case041/miyabi/run_speed.pbs
出力は、qsub を実行したディレクトリの c41-speed.o<ジョブ番号> に書かれる。Miyabi では、ジョブの実行中もこのファイルに書き足されるので、tail -f c41-speed.o* で進み具合を見られる。ジョブの最後に、1 回の計算を 1 行にまとめた一覧を出し、チェックサムを基準の値と比べる(OK、NG、既定以外の設定では no reference)。2 ノードでの出力:
=== summary (2 nodes)
H/48   stdpar     rc=0   s/step=0.10205   ec36499638244575 OK
H/48   stdpar-ovl rc=0   s/step=0.10010   ec36499638244575 OK
H/48   c3         rc=0   s/step=0.01508   ec36499638244575 OK
H/48   c3ov       rc=0   s/step=0.01449   ec36499638244575 OK
H/48   c3f32ov    rc=0   s/step=0.01200   b65b5a0b67e14afd OK
H/32   stdpar     rc=0   s/step=0.00896   d33bf4bdf3983bd4 OK
H/32   stdpar-ovl rc=0   s/step=0.00878   d33bf4bdf3983bd4 OK
H/32   c3         rc=0   s/step=0.00153   d33bf4bdf3983bd4 OK
H/32   c3ov       rc=0   s/step=0.00150   d33bf4bdf3983bd4 OK
H/32   c3f32ov    rc=0   s/step=0.00126   3c28d3a5ebaef9a1 OK
=== all runs OK
s/step は力の出力を含む 1 ステップの時間(TIMING の行)。一覧の上に出る TIMING_KERNELS は計算部分だけの時間。基準のチェックサム:
| 格子 | FP64(stdpar、stdpar-ovl、c3、c3ov) | FP32 保存(LBM_FP32=1) |
FP32 衝突(LBM_FP32=2) |
|---|---|---|---|
| H/48(20 + 200 ステップ) | ec36499638244575 |
6a28de6f5831daf7 |
b65b5a0b67e14afd |
| H/32(20 + 400 ステップ) | d33bf4bdf3983bd4 |
d5ae5874c7720640 |
3c28d3a5ebaef9a1 |
FP64 の設定は stdpar と同じチェックサムになり、ビット単位の確認になる。計算プログラムの位置引数は、H あたりのセル数、ステップ数、格子単位の U_b(0.05)、Re_H(40000)、Smagorinsky 定数(0.10)。複数ノードでは、設定は OMPI_MCA_mca_base_env_list(スクリプトの中で設定)で他のノードのランクに渡る。
4. 物理の計算
統計量と分布を取り、再開しながら進める計算。scripts/case041/miyabi/run_mpi_phys.pbs(複数 GPU)と run_single.pbs(1 GPU)が、キューの制限時間に収まる区切りで計算を続ける。区切りごとにチェックポイントを書き、次の区切りは前の区切りが終わってから投入する(依存関係のチェーンは使わない)。使い方は各スクリプトの先頭にある。例:
qsub -W group_list=$GROUP -l select=8 -v CASE_DIR=$CASE_DIR,TAG=h48,NH=48,TRANS=43200,TOTAL=400000 scripts/case041/miyabi/run_mpi_phys.pbs
これらのスクリプトは stdpar 版の実行ファイル(build.pbs)を使う。CUDA 版での 2026-10-27 の物理の計算は Flow2 の GB200 で行った。
5. 結果の可視化と実験値との比較
ログインノード。2026-10-29 に、3 区切りの H/48 の物理の計算で確かめた。
numpy と matplotlib のある Python:Miyabi のシステムの python3 は numpy が古く、matplotlib がないので、仮想環境を一度作る(~/.local に matplotlib がすでにあれば pip3 install --user --upgrade numpy でもよいが、システムの python3 を使うすべての場面に効く)。
module load python/3.11.15
python3 -m venv /work/$GROUP/$USER/venv-c41
/work/$GROUP/$USER/venv-c41/bin/pip install numpy matplotlib
PY=/work/$GROUP/$USER/venv-c41/bin/python
LDA の実験値との分布と QoI の比較(計算のすべての区切りを順に指定。約 20 秒):
RUN=$(ls -d $CASE_DIR/runs/h48/p* | paste -sd,)
$PY scripts/case041/compare_case041.py --figs $CASE_DIR/figs --run H48=$RUN --json $CASE_DIR/figs/qoi.json
14 枚の図(SIG15 の各位置での中心面と z/H = 1 の U、V、W とレイノルズ応力、壁近くの U、中心面の流線、QoI の収束)と qoi.json(X_R/H、前面と屋根の逆流、平均絶対誤差)を書く。このページの要約の図は次で作る。
LAST=$(ls -d $CASE_DIR/runs/h48/p* | tail -n 1)   # 最後の区切り(p01、p02、… の順に並ぶ)
$PY scripts/case041/make_summary.py --out $CASE_DIR/summary --run H48=$LAST \
    --qoi $CASE_DIR/figs/qoi.json --qoi-label H48=H48
firefox $CASE_DIR/summary/*.png         # 表示(ssh -X が必要。PC に写して見てもよい)
centreline_{U,urms,vrms}.{png,pdf}(x/H = -1.5、1、2、3)、qoi_table.{md,csv}、xr_convergence.{png,pdf} を書く。--run LABEL=... を増やすと、複数の計算を比べられる。
ParaView での瞬時場は 3 段階で作る(各ジョブが終わってから次の段階に進む)。
# 1. 最新のチェックポイントから速度の箱を書き出す(計算と同じノード数と設定。
#    統計を取り始めた後なら AVG_FROM は計算の TRANS)
CK=$(tail -1 $CASE_DIR/runs/h48/state | awk '{print $3}')
qsub -W group_list=$GROUP -l select=8 -v CASE_DIR=$CASE_DIR,NH=48,CK=$CK,AVG_FROM=43200,OUT=$CASE_DIR/runs/h48/inst scripts/case041/miyabi/inst_dump.pbs
そのジョブが終わってから:
# 2. 1 つの VTK ファイルにまとめる(ログインノード)
$PY scripts/case041/inst_to_vti.py $CASE_DIR/runs/h48/inst/inst $CASE_DIR/inst.vti --stride 2
# 3. ParaView の pvbatch で図を描く(ログインノード。Xvfb で仮想の画面を用意する)
mkdir -p $CASE_DIR/render
module load paraview/5.13.1
xvfb-run -a -s "-screen 0 2400x1400x24" pvbatch scripts/case041/render_inst.py $CASE_DIR/inst.vti $CASE_DIR/render 30 100
firefox $CASE_DIR/render/*.png          # 表示(ssh -X が必要。PC に写して見てもよい)
H/48 の書き出しは 1.7 GB(8 ランク)。--stride 2 で数秒、100 MB の .vti になる(付けなければ 1056 × 384 × 96 の全体)。.vti には U、|U|、Q((U_b/H)^2 単位)、固体の印が入る。render_inst.py は中心面の |U| と、レベルごとの Q の等値面(Q (H/U_b)^2 = 30、100)を描く。図 umag_y0.png、q_30.png、q_100.png が約 10 秒で $CASE_DIR/render にできる。Miyabi-G の ParaView のモジュール(5.13.1)は画面を必要とするので、xvfb-run を付ける。ssh -X(Mac では XQuartz)でログインすれば、GUI の paraview で .vti を直接開ける。ほかの方法:scripts/case041/miyabi/render_inst.pbs は、paraview.org の Linux x86_64 版 ParaView(PARAVIEW にそのディレクトリを指定)で、同じ描画を Miyabi-C(x86_64)のジョブとして行う。.vti を PC に写して、ParaView で開いてもよい。
Validation
| Tier | T2 — 単点比較 |
| QoI | X_R/H、U/U_b、レイノルズ応力 |
| Reference | ERCOFTAC case 41(Martinuzzi & Tropea、LDA)、X_R/H = 1.62 |
| Gate | — ゲートなし |
| 注 | H/16〜H/64 の格子で実験と比べ、X_R は H/64 で格子について収束。T0 は解析解との比較に限るので T0 ではない |
ソース
計算プログラム、halo と計算の重ね合わせ、CUDA 版は、公開版の main に入っている(2026-10-29 にマージ)。scripts/case041/ に、データの取得、流入、比較、Miyabi-G のジョブのスクリプトがある。halo、重ね合わせ、CUDA の各モードの速度とチェックサムを確かめるジョブは miyabi/run_speed.pbs。実験データは ERCOFTAC Classic Collection の case 41 による。