ローカル LLM の比較
英語 | 日本語
OpenRheo は、クラウドの高性能な LLM を教師に、現場のローカル LLM を実行役にする 2 段の構成を前提にしています。このページでは、ローカル LLM を GH200 で測った結果で比べます。エージェントが LLM に何を聞き、答えをどう確かめるかは ローカル LLM のエージェント にあります。
ローカル LLM を動かす場所
GH200 の 1 ノードのメモリは、Grace(CPU)側が 120,857 MB、Hopper(GPU)側が 97,280 MB です(2026-07-27 に計測)。ローカル LLM は ollama で GPU の上で動かしていて、下の測定もすべてこの形で行いました。モデルのファイルは qwen2.5 の 7b が 4.7 GB、14b が 9.0 GB です。96 GB の GPU には、14b と 72b のモデル(約 9 GB と 45 GB)を同時に載せておけます。同じ GPU で LBM の計算と LLM を同時に動かした場合は、まだ測っていません。
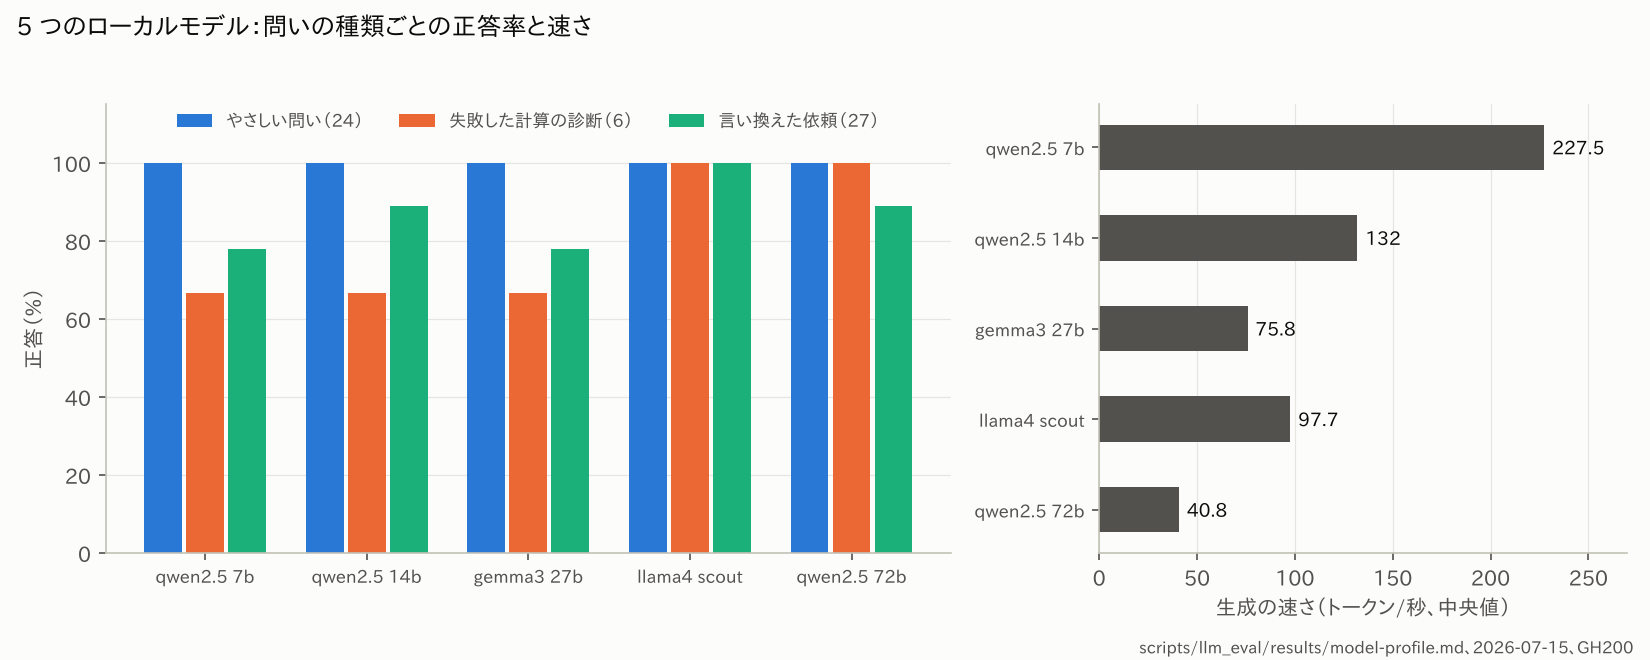
測定(2026-07-15、GH200 の上の ollama、4 ビット量子化)
| モデル | やさしい問い(24) | 失敗した計算の診断(6) | 言い換えた依頼(27) | 生成の速さ、中央値(トークン/秒) | 応答時間、中央値(秒) |
|---|---|---|---|---|---|
| qwen2.5 7b | 24 | 4 | 21 | 227.5 | 0.3 |
| qwen2.5 14b | 24 | 4 | 24 | 132.0 | 0.6 |
| gemma3 27b | 24 | 4 | 21 | 75.8 | 1.2 |
| llama4 scout | 24 | 6 | 27 | 97.7 | 1.2 |
| qwen2.5 72b | 24 | 6 | 24 | 40.8 | 1.7 |
やさしい問いには、どのモデルも全問答えます。差が出るのは、失敗した計算をログから診断する問いと、言い換えた依頼だけです。そこで、呼び出しごとにモデルを選び分けています(2026-08-21)。ほとんどの呼び出しは 7b か 14b のモデルで、72b のモデルは診断だけに使います。
教師と実行役の 2 段
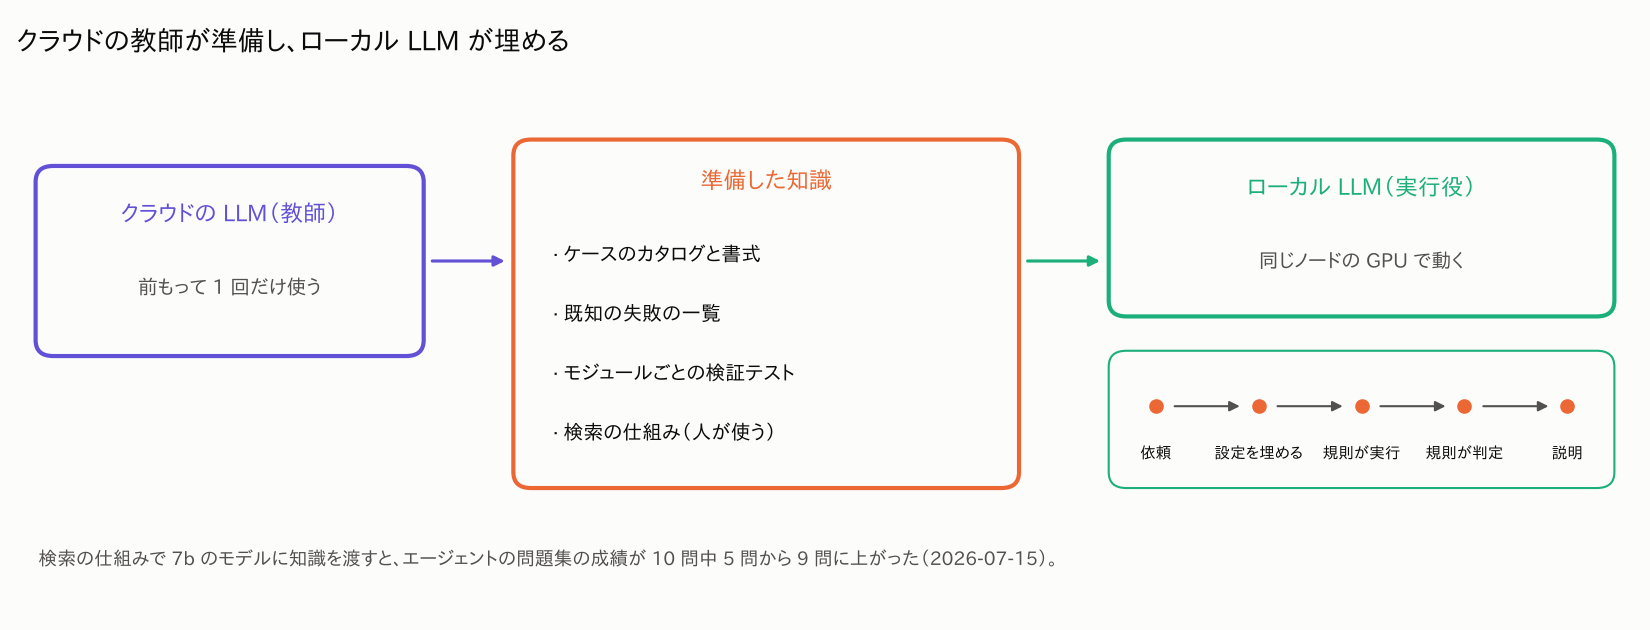
- 教師(クラウド):前もって 1 回だけ、ケースのカタログと書式、既知の失敗の一覧、モジュールごとの検証テストを用意します。人が使う検索の仕組みも用意します。
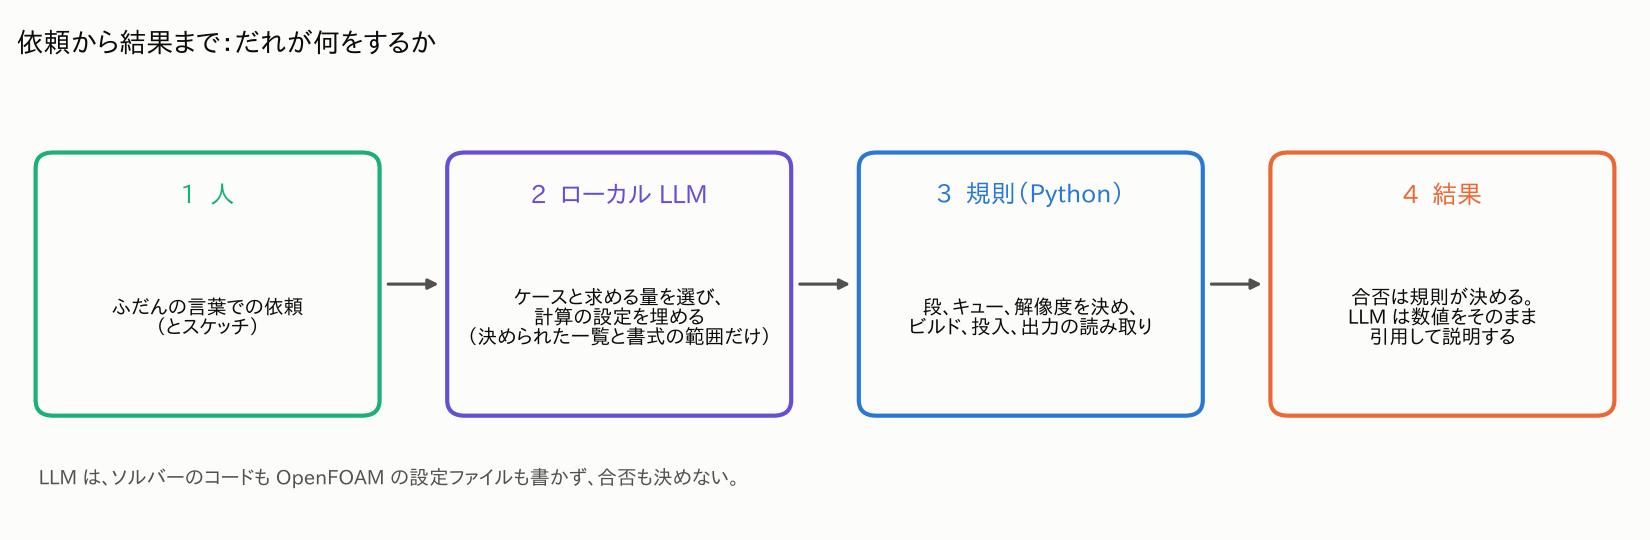
- 実行役(ローカル):依頼ごとに、決められた範囲の答えを埋めます。どの段で解くか、計算の投入、合否の判定は、エージェントの規則が行います。
準備した知識があれば、小さなモデルでも十分に働きます。検索の仕組みで 7b のモデルに知識を渡すと、エージェントの問題集の成績が 10 問中 5 問から 9 問に、知識の問題集の成績が 8 問中 1 問から 8 問に上がりました(2026-07-15)。
いまの状態
- ダクト系の梯子(1 次元 → OpenFOAM → LBM)は、2026-07-16 に最後まで自動で通りました。ただ、その計算を本物の LLM が動かしたのか、代わりの仕組み(モック)が動かしたのかは、記録に書かれていません。
- 計算機で動かす LLM の既定のモデルは、いまも
qwen3:14bです。上の測定は qwen2.5 で行いました。 - 数値は 2026-07-15 時点のものです。モデルの進歩が速いので、ときどき測り直す必要があります。