ローカル LLM のエージェント
英語 | 日本語
エージェント(scripts/orheo_agent)は、ふだんの言葉で書かれた依頼を、マルチフィデリティの段の計算に変えます。ローカル LLM は依頼を読み、決められた範囲の答えをいくつか埋めるだけです。どの段で解くか、どのキューにジョブを出すか、いつ止めるか、結果が正しいかは、すべて Python のプログラムが決めます。このページでは、LLM に何を聞くか、間違った答えをどう受け止めるか、5 つのローカルモデルで測った結果、残っている課題を説明します。設計の方針は Architecture に、モデルの比較とクラウドの教師の仕組みは ローカル LLM の比較 にあります。
LLM に聞くこと
| 呼び出し | LLM が答えること | 答えの範囲 |
|---|---|---|
| INTERPRET | どのケースで、どの量を求めるか | カタログにあるケースの一覧と、決められた量の語彙 |
| SPEC | 計算の設定 | ケースの書式ファイルにある項目、型、範囲 |
| REPORT | 結果の説明 | 「数値はそのまま引用し、作らない」 |
| NEXT | 次に何をするか | 決められた選択肢 |
| DIAGNOSE | 計算が失敗した理由 | 既知の失敗の一覧(playbook)から 1 つ |
どの呼び出しでも、ollama に書式つきの JSON で答えさせます。温度は 0 で、乱数の種も固定です。答えは検査し、合わなければ理由を添えて聞き直します。3 回まで聞き直しても合わなければ、決めておいた既定の答えを使います。弱いモデルでも、答えの質が下がるだけで、処理が止まることはありません。LLM は、キューや計算時間を選ぶことも、コードを書き換えることも、ソルバーの出力をそのまま読むことも、合否を決めることもしません。OpenFOAM の設定ファイルも書きません。設定ファイルは、確かめ済みのひな形に値を入れて作ります(マルチフィデリティ を参照)。
5 つのローカルモデルで測った結果
評価の問題集(scripts/llm_eval)を、GH200 の上の ollama で解かせました(2026-07-15)。やさしい問いには、どのモデルも全問答えます。差が出るのは、失敗した計算をログから診断する問いと、言い換えた依頼だけでした。
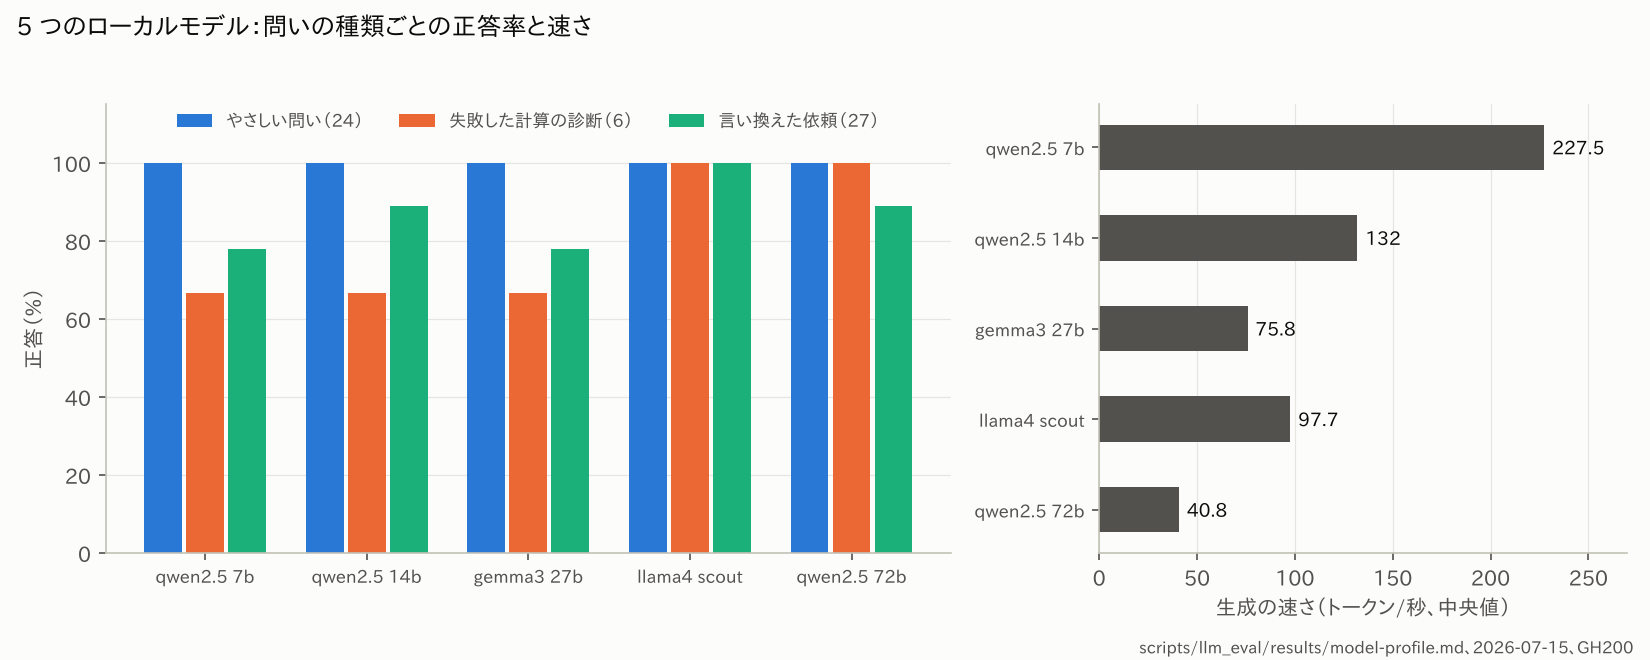
そこで、呼び出しごとにモデルを選び分けることにしました(2026-08-21)。大きなモデルを使うのは DIAGNOSE だけです。96 GB の GH200 には、14b と 72b のモデルを同時に載せておけます。
LLM に渡す情報
エージェントは文書を検索しません。計算の状態に応じて選んだ、小さな情報のまとまり(scripts/orheo_agent/packs/)を LLM に渡します。中身は、ケースのカタログ、ケースの書式ファイル、計算機の使い方の注意、既知の失敗の一覧、例です。build_pack.py は、カタログと書式ファイルが食い違っていないかを確かめます。
これとは別に、人が使う検索の仕組み(scripts/rag/、bge-m3 の埋め込み)があり、コードや記録についての質問に答えます。20 問の試験では、正しい断片が 19 問で 1 番目に、20 問すべてで上位 3 つに入りました。この検索の仕組みで 7b のモデルに知識を渡すと、エージェントの問題集の成績が 10 問中 5 問から 9 問に上がりました。
モジュールと関門
物理は、同じ約束(パラメータ、状態、初期化、1 ステップ進める関数)を持つモジュールとして書き、それぞれに検証用の ctest を 1 つ付けています。エージェントがケースを加えるときに、300 行のベンチマークを写して直すのではなく、モジュールを組み合わせればよいようにするためです。ギャラリーの 80 ケースのうち、9 ケースは直接の関門を、28 ケースはモジュールの関門で確かめられ、43 ケースには関門がありません(検証水準一覧 を参照)。
試して見送ったもの
- PINN の段(計算の結果で学習したネットワークに、計算と計算のあいだの値を答えさせるもの)は、2026-07-15 に測って採用しないことにしました。信頼度の較正の基準を満たしませんでした(いちばんよい設定で 0.60、基準は 0.80 以上)。
- ローカルモデルの追加の学習(ファインチューニング)は取りやめました。知識は、渡す情報のまとまりと検索の仕組みで補います。
- スケッチからの形状は、ひな形を使う方式だけができています(文章から 8 種類の形を作る方式と、STL ファイルをそのまま使う方式)。画像を読むモデルで図面を読む方式は、まだ作っていません。
残っている課題
- REPORT は長さしか検査しておらず、書かれた数値を計算の数値と照らし合わせていません。
- 計算機で動かす LLM の既定のモデルは、いまも
qwen3:14bです。上の測定は、すべて qwen2.5 で行いました。 - 長いログからの失敗の診断は、どのモデルも 6 問中 3 問しか正しく答えられません。
build_pack.pyは、いま、カタログと定常 RANS の書式ファイルの食い違いを 8 件報告しています。- 設計の記録にある Nsight でのプロファイルの仕組みと、デモのリハーサル用のスクリプトは、作っていません。
設計の記録
凍結した記録です。更新せず、日本語にも訳しません。
- local-llm-ops-design.md — エージェントと LLM の使い方
- module-architecture-design.md — モジュールと検証の関門
- opencae-demo-design.md — OpenCAE 勉強会のデモ
- pinn-tier-design.md — PINN の段
- sketch-to-geometry-design.md — スケッチからの形状
- lbm-landscape-and-methods.md — ほかの LBM のコードと、そのライセンス